


이미 소장하고 있다면 판매해 보세요.
- 국내배송만 가능
- 문화비소득공제 가능
이 상품의 태그
상세 이미지

책소개
목차
|
1장 탐색적 데이터 분석
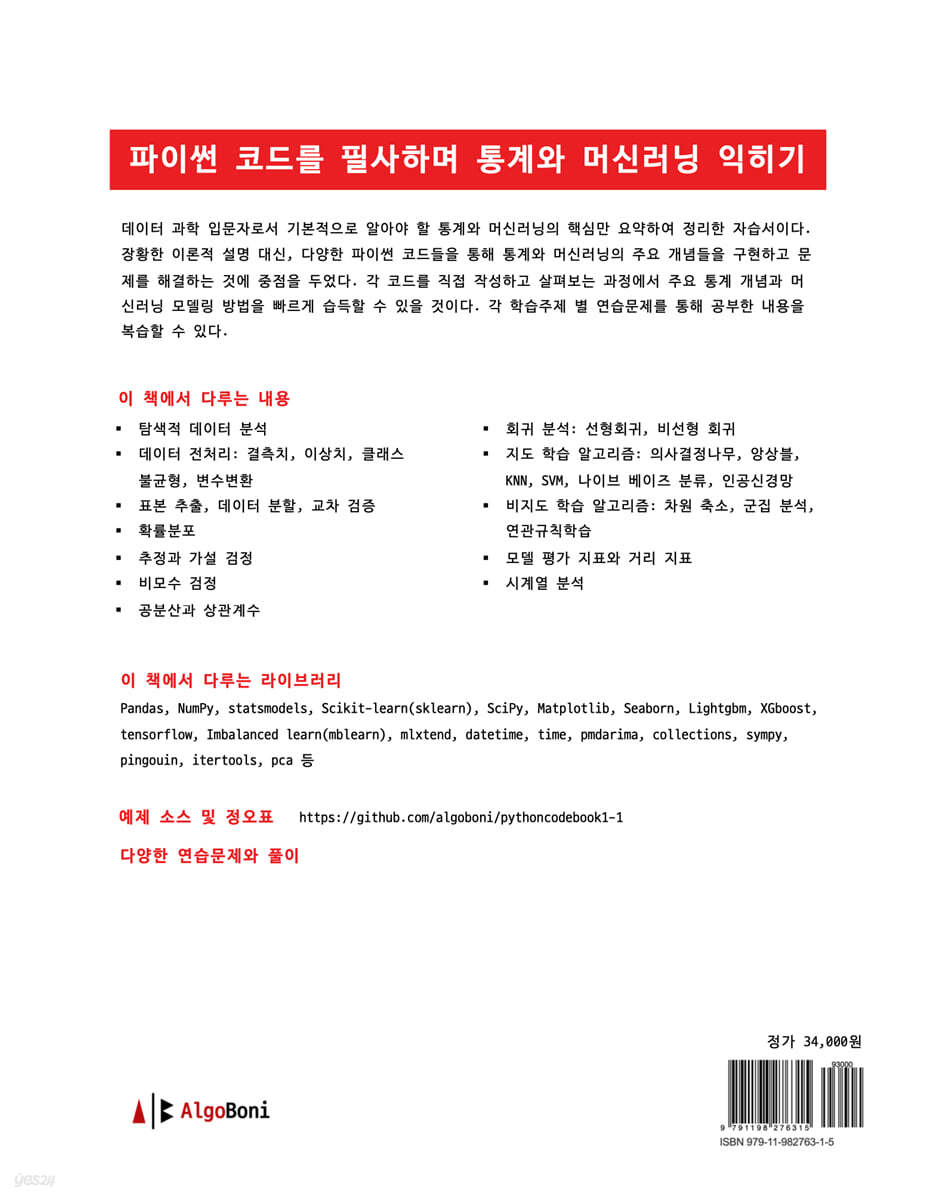
1-1. 공통 데이터 불러오기 데이터 기본정보 확인 기술 통계 1-2. 질적변수 도수분포표, 상대도수분포표 상관계수: 스피어만 순위상관계수, 켄달의 타우 질적변수 탐색 시각화 1-3. 양적변수 도수분포표, 상대도수분포표 계산적 대푯값 위치적 대푯값 절대적 산포도 상대적 산포도 왜도, 첨도 상관계수: 피어슨의 적률상관계수 양적변수 탐색 시각화 -연습문제와 풀이 2장 전처리 2-1. 결측치 처리 결측치 확인 Zero imputation & Constant imputation 대푯값으로 채우는 방법 단순확률대치법 다른 변수들로부터 모델링을 하여 결측값을 예측하는 방법 보간법 실제값과 대치값 비교 2-2. 이상치 처리 절단 조정 클리핑 2-3. 클래스 불균형 처리 클래스 불균형 데이터 생성하기 랜덤오버샘플링 SMOTE Borderline SMOTE K-means SMOTE SVM SMOTE ADASYN 오버샘플링된 데이터로 분류 학습 및 결과 비교 2-4. 변수변환 2-4-1. 수치형 변수 변환 표준화 최소최대 스케일링 Robust scaling Quantile scaling Feature scaling한 데이터로 로지스틱 회귀 분석 및 결과 비교 로그 변환 거듭제곱변환 Target scaling한 데이터로 시각화, 선형 회귀 분석 및 결과 비교 순위로 변환 구간 분할 2-4-2. 범주형 변수 변환 원핫인코딩 더미코딩 숫자로 표현된 범주형 특성 변환 레이블 인코딩 특징 해싱 빈도 인코딩 -연습문제와 풀이 3장 표본추출, 데이터 분할, 교차검증 3-1. 표본 추출 단순랜덤추출법 계통추출법 집락추출법 층화추출법 3-2. 데이터 분할 일반적 데이터 분할 및 홀드아웃 방법 Shuffle split K-fold 분할 Stratified K-fold 분할 Group K-fold 분할 3-3. 교차 검증 분할 샘플들로 교차 검증 파라미터 후보들로 교차 검증 -연습문제와 풀이 4장 확률분포 4-1. 특수한 이산형 확률분포들 베르누이 분포 이항분포 음이항분포 기하분포 초기하분포 포아송 분포 4-2. 특수한 연속형 확률분포들 균일분포 정규분포와 표준정규분포 지수분포 감마분포 카이제곱분포 t분포 F분포 -연습문제와 풀이 5장 추정과 가설 검정 5-1. 일표본 (One-sample) 모평균의 추정과 가설 검정: Z분포, t분포 1종 오류와 2종 오류 모비율의 추정과 가설 검정: Z분포 모분산의 추정과 가설 검정: 카이제곱분포 5-2. 이표본 (Two-sample) 독립표본 모평균 차이의 추정과 가설 검정: Z분포, t분포 대응표본 모평균 차이의 추정과 가설 검정: Z분포, t분포 모비율 차이의 추정과 가설 검정: Z분포 모분산 비의 추정과 가설 검정: F분포 5-3. 분산분석의 가정 정규성 검정 k표본 등분산 검정 (Levene) k표본 등분산 검정 (Bartlett) 5-4. 분산분석: F분포 등분산인 one-way ANOVA 이분산인 one-way ANOVA 등분산인 two-way ANOVA (모수인자-모수인자) 등분산인 two-way ANOVA (모수인자-변량인자) -연습문제와 풀이 6장 비모수 검정 6-1. 카이제곱검정: 카이제곱분포 적합성 검정: 다항모집단 비율의 차이 독립성 검정: 한 모집단 내 여러 수준의 차이 동질성 검정: 여러 (부)모집단 간 여러 수준에 대한 차이 6-2. Run 검정: Run 검정표, Z분포 일표본 Run 검정 이표본 Run 검정 6-3. 이항변수 데이터 검정: 카이제곱분포 맥니머 검정 코크란Q 검정 6-4. 부호, 순위 데이터 검정 일표본 부호 검정: 이항분포, Z분포 이표본 부호 검정: 이항분포, Z분포 일표본 윌콕슨 부호순위 검정: 윌콕슨 부호순위 검정표, Z분포 이표본 윌콕슨 부호순위 검정: 윌콕슨 부호순위 검정표, Z분포 윌콕슨 순위합 검정(만 위트니 U검정): 윌콕슨 순위합 검정표, Z분포 6-5. k표본 순위 데이터 검정 크러스컬 월리스 검정: 크러스컬 월리스 검정표, 카이제곱분포 프리드먼 검정: 프리드먼 검정표, 카이제곱분포 -연습문제와 풀이 7장 공분산과 상관계수 7-1. 공분산 7-2. 상관계수 -연습문제와 풀이 8장 회귀 분석 8-1. 선형 회귀 8-1-1. 단순 선형 회귀 8-1-2. 다중 선형 회귀 영향치 판단 VIF 계산 변수 선택과 가능도 잔차 분석 8-1-3. 규제 선형 회귀 릿지 회귀 라쏘 회귀 엘라스틱 넷 8-1-4. 일반화 선형 회귀 로지스틱 회귀 포아송 회귀 8-1-5. 아웃라이어에 강한 선형 회귀 Robust regression Quantile regression 8-2. 비선형 회귀 다항 회귀 스플라인 회귀 -연습문제와 풀이 9장 지도 학습 알고리즘 9-1. 의사결정나무와 앙상블 9-1-1. 의사결정나무 9-1-2. 앙상블 배깅 부스팅 랜덤 포레스트와 Extra-trees 스태킹 9-2. KNN 9-3. SVM 9-4. 나이브 베이즈 분류 베이즈 통계 나이브 베이즈 분류 9-5. 인공신경망 다층 퍼셉트론 -연습문제와 풀이 10장 비지도 학습 알고리즘 10-1. 차원 축소 주성분 분석 요인 분석 독립성분 분석 음수 미포함 행렬 분해 다차원 척도법 원본 데이터와 차원 축소 데이터로 적합한 모델 성능 비교 10-2. 군집 분석 10-2-1. 계층적 군집 분석 10-2-2. 비계층적 군집 분석 K-means clustering DBSCAN 혼합분포군집 SOM 10-3. 연관규칙학습 -연습문제와 풀이 11장 모델 평가 지표와 거리 지표 11-1. 회귀모델 평가 지표 11-2. 분류모델 평가 지표 11-3. 군집모델 평가 지표 실제 군집값이 없는 경우 실제 군집값이 있는 경우 11-4. 거리 지표 연속형 변수의 거리들 범주형 변수의 거리들 -연습문제와 풀이 12장 시계열 분석 12-1. 시계열 탐색적 분석 12-1-1. 일반적 EDA 12-1-2. 시계열에 특화된 EDA 정상성 확인 자기상관 확인 시계열 분해 12-2. 시계열 데이터 전처리 시계열 데이터 다루기 시계열 빈도 변경 (업샘플링, 다운샘플링) 결측치 처리 차분과 변환 12-3. 시계열 모델링 및 평가 박스-젠킨스 방법과 ARIMA 자동 차수 선택 방법과 ARIMA -연습문제와 풀이 |
저자 소개 1
이화여자대학교에서 중어중문학을 전공한 후, 스마트폰, 시스템 반도체 기업 등에서 해외영업 및 마케팅 업무를 하였다. 이후, 현장의 데이터들을 효과적으로 업무에 활용할 방법을 찾고자 노베이스 비전공자의 어려움을 무릅쓰고 데이터 과학의 세계에 뛰어들었다. 알아갈수록 새로운 것이 쏟아져 나오는 이 흥미로운 탐험을 계속하며, 하루하루 충실하게 살고 있다.
빅데이터 전문가 국비지원 교육 수료(2021) , 국가공인 자격증 데이터분석전문가 ADP 취득(2022).
KOPIS 빅데이터 분석 공모전 장려상(2022) , KHIDI 공공데이터 활용 아이디어 공모전 우수상(2023), 농림축
이화여자대학교에서 중어중문학을 전공한 후, 스마트폰, 시스템 반도체 기업 등에서 해외영업 및 마케팅 업무를 하였다. 이후, 현장의 데이터들을 효과적으로 업무에 활용할 방법을 찾고자 노베이스 비전공자의 어려움을 무릅쓰고 데이터 과학의 세계에 뛰어들었다. 알아갈수록 새로운 것이 쏟아져 나오는 이 흥미로운 탐험을 계속하며, 하루하루 충실하게 살고 있다.
빅데이터 전문가 국비지원 교육 수료(2021) , 국가공인 자격증 데이터분석전문가 ADP 취득(2022).
KOPIS 빅데이터 분석 공모전 장려상(2022) , KHIDI 공공데이터 활용 아이디어 공모전 우수상(2023), 농림축산식품 공공/빅데이터 활용 창업경진대회 팜맵 데이터 최우수상(2023) 수상.
빅데이터 전문가 국비지원 교육 수료(2021) , 국가공인 자격증 데이터분석전문가 ADP 취득(2022).
KOPIS 빅데이터 분석 공모전 장려상(2022) , KHIDI 공공데이터 활용 아이디어 공모전 우수상(2023), 농림축산식품 공공/빅데이터 활용 창업경진대회 팜맵 데이터 최우수상(2023) 수상.
조정임의 다른 상품
품목정보
- 발행일
- 2023년 09월 25일
- 쪽수, 무게, 크기
- 426쪽 | 182*235*30mm
- ISBN13
- 9791198276315
출판사 리뷰
|
대상 독자
이 책으로 학습하기 위해서는 기본적인 파이썬 프로그래밍 능력과 데이터 과학에 대한 기초 지식이 필요하다. 이러한 배경지식이 없는 독자라면, 이 책의 내용을 학습하기 전에 기초적인 파이썬 언어 사용법을 익히고, 데이터 과학에 대한 기본 개념을 살펴보기를 권한다. 비록 이러한 배경지식이 없더라도, 이 책의 예제 코드들을 직접 작성하며 실행해보는 동시에, 그 때 그 때 등장하는 모르는 개념들을 찾아가며 학습하는 방법도 시도해 볼 수 있다. 사용 가이드 이 책에 나온 파이썬 개발 환경(Integrated Development Environment)은 Jupyter lab version 3.0.12이다. 컴퓨터에 Jupyter lab을 설치한 후, 각종 라이브러리들을 추가로 설치해서 이 책의 코드들을 실행해 볼 수 있다. 이 방법이 여의치 않은 경우에는 별도의 설치가 필요 없는 Colaboratory를 사용하는 방법도 있다. 웹(https://colab.research.google.com/)을 통해서 코드를 작성하고 실행하기 때문에 디바이스나 장소에 구애 받지 않고 사용이 가능하다. 기본적인 라이브러리도 설치가 되어 있기 때문에 처음 개발 환경을 셋팅하느라 소요되는 시간을 절약할 수 있다. 다만 일부 라이브러리는 추가로 설치해야 한다. 일부 코드 블럭에서는 라이브러리나 클래스를 불러오는 과정이 생략되어 있으므로, 주요 파이썬 라이브러리의 약자와 클래스의 출처를 염두에 두고 학습하기를 권한다. 예를 들어, NumPy는 np, seaborn은 sns로 사용하며, Pandas에서 DataFrame, read_csv 등 클래스를 불러와 사용하는 경우이다. 이 책의 목차는 학습의 흐름에 맞는 순서대로 구성이 되어 있지만, 이미 알고 있는 부분은 건너뛰어도 무방하다. 각 학습 주제에 대해 추가적인 정보가 필요할 수 있으며, 구글링이나 다른 도서를 통해 내용을 보충하기를 권한다. 어떤 코드들은 데이터나 모델링 과정에서 무작위적(Random) 요소가 있어서 책에 나온 결과대로 출력이 되지 않을 수도 있지만, 이는 코드의 문제가 아닌 자연스러운 결과이다. 일부 시각화 출력은 편집 상 편의를 위해 크기를 조정하였기 때문에 실제 출력 크기와 다를 수 있다. 코드 번호가 중간에 한두줄 비는 경우도 편집된 경우이며 코드의 정상적 실행에는 영향을 미치지 않는다. |
사락 별점0
혜택 및 유의사항밑줄0
혜택 및 유의사항
30,600원
총 1개
30,600원
