소득공제
PDF
eBook
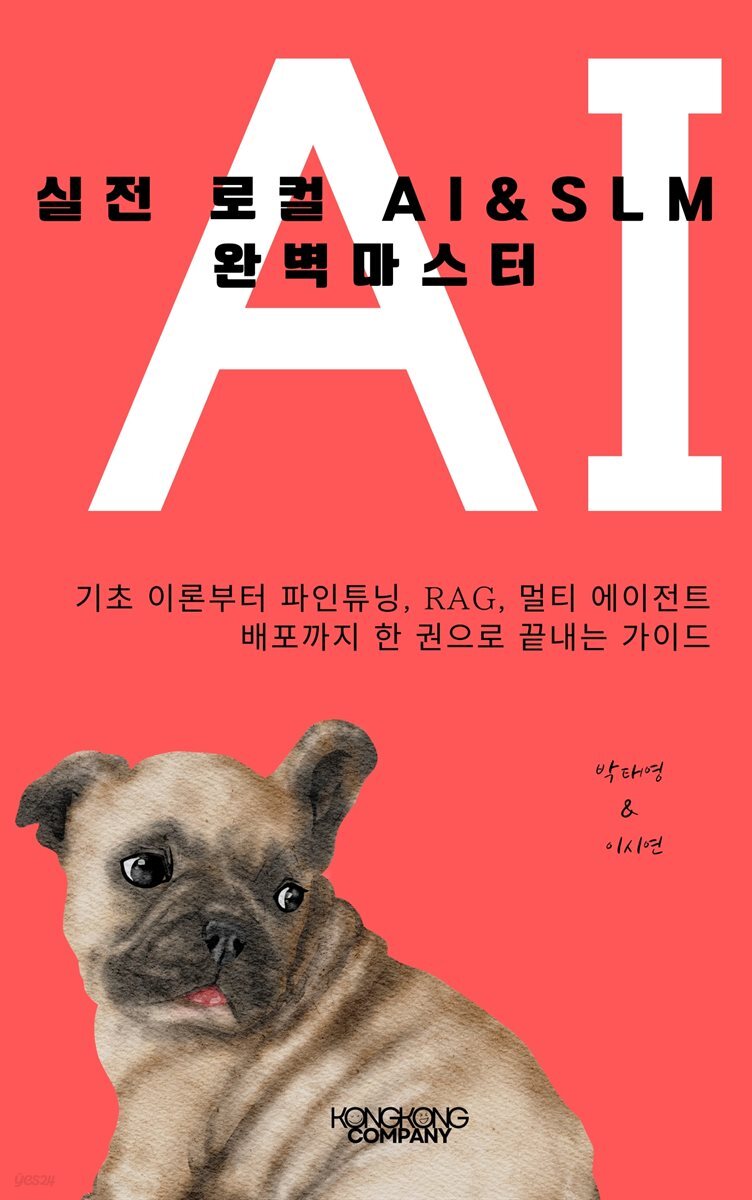
실전 로컬 AI & SLM 완벽 마스터
기초 이론부터 파인튜닝, RAG, 멀티 에이전트 배포까지 한 권으로 끝내는 가이드
스마트한 PDF 필기 기능을 사용해 보세요!
- PDF 안내
-
이 상품은 구매 후 지원 기기에서 예스24 eBook앱 설치 후 바로 이용 가능한 상품입니다.
소개
목차
|
제목: 실전 로컬 AI & SLM 완벽 마스터
부제: 기초 이론부터 파인튜닝, RAG, 멀티 에이전트 배포까지 한 권으로 끝내는 가이드 서문 · 왜 지금, 당신의 노트북에서 AI가 돌아가야 하는가 Part 1: SLM, 새로운 시대의 시작 (개념과 트렌드) 초보자를 위한 LLM과 SLM의 차이점, 내부 동작 원리부터 최신 아키텍처 트렌드까지 AI의 기반 지식을 다집니다. 1장: 거대 언어 모델(LLM)의 시대, 그리고 SLM의 등장 1.1. 세상을 바꾼 LLM: ChatGPT, GPT-4, 그리고 그 이후 1.2. LLM의 그림자: 높은 비용, 느린 추론, 통제의 어려움 1.3. 대안의 부상: SLM(Small Language Model)이란 무엇인가? 1.4. LLM vs SLM: 무엇을, 언제, 어떻게 선택해야 하는가? 1.5. 기업이 로컬 SLM을 선택하는 3대 이유: 보안, 프라이버시, 지연 시간(Latency) 2장: SLM의 작동 원리와 차세대 아키텍처 2.1. 트랜스포머(Transformer) 아키텍처 핵심 원리 다시 보기 2.2. 토큰, 임베딩, 어텐션: SLM 내부 동작 흐름 완벽 이해하기 2.3. 작게 만드는 기술: 파라미터 대비 성능(PtoP) 극대화 전략 2.4. 대표적인 SLM 모델 심층 분석 (Llama, Phi, Gemma, Qwen 등) 2.5. 트랜스포머의 대안과 진화: MoE(전문가 혼합), Mamba(맘바), 멀티모달(vSLM) Part 2: SLM 직접 만져보기 (기초 실습 및 로컬 환경 구축) 코딩 입문자도 따라 할 수 있는 개발 환경 구축부터, 허깅페이스 생태계 이해 및 오프라인 로컬 구동까지 실습합니다. 3장: 나의 첫 SLM: 개발 환경 구축하기 3.1. 필수 준비물: Python, Jupyter Notebook / VS Code 환경 세팅 3.2. 핵심 라이브러리 설치: PyTorch, Transformers, Accelerate 3.3. GPU 사용을 위한 CUDA 설정 및 클라우드(Colab) 환경으로 쉽게 시작하기 3.4. [실습] "Hello, SLM!" - 첫 모델 로드하고 텍스트 생성하기 4장: 허깅페이스(Hugging Face)와 SLM 생태계 완전 정복 4.1. 허깅페이스: AI 개발자를 위한 세계 최대의 놀이터 4.2. Model Hub & Datasets: 원하는 모델 찾고 파인튜닝용 데이터 탐색하기 4.3. Transformers 라이브러리의 핵심, pipeline 활용법 4.4. [실습] pipeline으로 5줄 만에 텍스트 요약, 질문 답변 봇 만들기 5장: 내 PC를 AI 서버로: 로컬 구동과 프롬프트 엔지니어링 4.1. 인터넷 없이 구동하는 로컬 AI의 표준 도구: Ollama, LM Studio 활용법 4.2. SLM을 위한 프롬프트 최적화: CoT(Chain of Thought)와 Few-shot 기법 4.3. 구조화된 출력(JSON Mode) 강제하기 4.4. [실습] 인터넷 연결 없이 내 노트북에서 8B 급 모델 구동 및 DSPy로 프롬프트 최적화하기 Part 3: SLM, 나만의 모델로 만들기 (파인튜닝과 경량화) 현업 개발자를 위한 핵심 파트입니다. 내 데이터를 주입하는 파인튜닝 기술과 모델을 극도로 가볍게 만드는 양자화 기법을 배웁니다. 6장: 데이터 준비와 파인튜닝(Fine-tuning)의 기초 6.1. 파인튜닝이란? 왜 필요한가? (범용 지식 vs 도메인 특화 모델) 6.2. 모델의 성능은 데이터가 결정한다: 고품질 Instruction 데이터셋 만들기 6.3. 강력한 무기, 합성 데이터(Synthetic Data): LLM을 이용해 SLM 학습용 데이터 생성하기 6.4. [실습] 전체 파인튜닝(Full Fine-tuning)으로 특정 말투를 흉내 내는 챗봇 만들기 7장: 경량화 튜닝 기법(PEFT)으로 똑똑하게 튜닝하기 7.1. PEFT(Parameter-Efficient Fine-Tuning)의 필요성 7.2. LoRA(Low-Rank Adaptation): 가장 인기 있는 경량화 튜닝 기법의 작동 원리 7.3. 메모리 한계를 넘는 QLoRA와 FSDP(다중 GPU 분산 학습) 7.4. [실습] 저사양 GPU에서 사내 고객 CS 데이터를 바탕으로 전문 상담 챗봇 파인튜닝하기 8장: 내 의도대로 대답하게 만들기: 모델 정렬(Alignment) 8.1. RLHF의 한계를 극복하는 최신 트렌드: DPO(직접 선호도 최적화)와 ORPO 8.2. KTO(Kahneman-Tversky Optimization): 좋아요/싫어요 데이터만으로 튜닝하기 8.3. [실습] 환각(Hallucination)을 줄이고 사내 정책을 준수하도록 DPO 학습 및 가드레일 적용하기 9장: 모델 경량화(Quantization): 더 가볍고 빠르게 만들기 9.1. 양자화(Quantization)란? (FP16, INT8, INT4에서 2-bit 시대로) 9.2. bitsandbytes 라이브러리를 활용한 양자화 로딩 9.3. 최신 모델 포맷 이해하기: GGUF vs AWQ vs EXL2 9.4. [실습] Llama.cpp를 활용한 GGUF 변환 및 극한의 메모리 리소스 사용량 비교 Part 4: 실전 애플리케이션! RAG와 에이전트 시스템 RAG(검색 증강 생성)의 기초부터 심화 기법을 익히고, 스스로 판단하고 행동하는 최신 AI 에이전트 워크플로우를 구축합니다. 10장: RAG 기초와 한계 극복 10.1. 언어 모델의 한계(환각, 최신 정보 부족)와 RAG의 필요성 10.2. 파인튜닝 vs RAG: 무엇을, 언제, 어떻게 선택해야 하는가? 10.3. 한국어에 특화된 임베딩 모델과 벡터 DB(FAISS, ChromaDB)의 역할 10.4. [실습] SLM과 RAG를 결합하여 내 문서 기반의 Q&A 챗봇 만들기 11장: Advanced RAG: 검색 품질 극대화 전략 11.1. 하이브리드 검색과 Reranker 모델을 활용한 정확도 향상 11.2. 텍스트 청킹(Chunking)의 기술과 최적화 11.3. 정보의 연결성과 문맥을 이해하는 Graph RAG 및 Self-RAG 11.4. [실습] 수천 페이지의 복잡한 PDF 문서를 완벽히 분석하는 로컬 RAG 시스템 구축 12장: 스스로 일하는 SLM: 에이전틱 워크플로우(Agentic Workflow) 12.1. 텍스트 생성을 넘어 도구(Tool)를 사용하는 SLM (Function Calling) 12.2. 에이전트 프레임워크 핵심: LangChain vs LlamaIndex 비교 12.3. [실습] 웹 검색, 사내 DB 조회, 이메일 발송을 자동화하는 미니 비서 만들기 13장: 멀티 에이전트 오케스트레이션 (Multi-Agent Systems) 13.1. 단일 모델의 한계를 넘는 다중 에이전트 협업 로직 13.2. AutoGen과 LangGraph를 활용한 복잡한 워크플로우 설계 13.3. [실습] 기획자 SLM, 개발자 SLM, 리뷰어 SLM이 협업하여 코드 작성하기 Part 5: 상용화 및 배포 (클라우드부터 엣지 디바이스까지) 개발된 모델을 서비스 시나리오에 맞게 배포하고 유지보수하는 아키텍처와 엔지니어링 스킬을 다룹니다. 14장: 서버 및 클라우드 배포 최적화 전략 14.1. 배포 시나리오별 최적의 전략 수립 (로컬 vs 온프레미스 vs 클라우드) 14.2. 높은 처리량(Throughput)을 위한 vLLM과 Paged Attention 원리 14.3. 클라우드 서버 배포: FastAPI와 Docker를 이용한 무중단 API 서버 구축 14.4. [실습] FastAPI와 vLLM을 이용해 파인튜닝된 모델을 고성능 API로 서빙하기 15장: 진정한 온디바이스: 모바일 및 엣지 디바이스 배포 15.1. Apple 생태계(Mac/iOS) 개발자를 위한 MLX 프레임워크 100% 활용법 15.2. 스마트폰(iOS/Android)에 SLM 이식하기 (ExecuTorch, CoreML) 15.3. 브라우저에서 바로 도는 AI: WebGPU와 Transformers.js 활용 16장: SLM의 미래와 책임감 있는 사용 (SLM-Ops) 16.1. 프로덕션 환경에서의 모델 성능 모니터링 및 LLMOps(SLMOps) 파이프라인 16.2. AI 윤리: 편향, 공정성, 투명성 문제와 데이터 프라이버시 16.3. SLM의 미래: 더 작고, 더 똑똑하고, 더 멀티모달하게 16.4. 오픈소스 커뮤니티와 함께 성장하기 부록 (Appendix) 부록 A · SLM 개발자를 위한 파이썬 기초 완벽 정리 A.1 변수, 자료형, 연산자 A.2 리스트, 튜플, 딕셔너리, 집합 A.3 문자열과 인코딩 A.4 조건문과 반복문 A.5 함수와 람다 A.6 클래스와 객체지향 A.7 모듈, 패키지, 가상환경 A.8 파일 입출력과 경로 A.9 예외 처리와 로깅 A.10 타입 힌트와 docstring 부록 B · 용어 정리 및 상황별 추천 SLM 모델 가이드 B.1 AI·SLM 핵심 용어 사전 B.2 시나리오별 추천 SLM 가이드 B.3 2026년 추천 SLM Top 10 카탈로그 부록 C · 2026년 하드웨어별 SLM 벤치마크 및 추천 스펙 C.1 NVIDIA GPU별 추천 SLM 및 추론 속도 C.2 Apple Silicon (M1~M4 Ultra) 벤치마크 C.3 AMD GPU (ROCm) 지원 현황 C.4 NPU(신경망 처리 장치) ? AI PC의 기준 C.5 하드웨어 구매 가이드: 예산별 추천 C.6 클라우드 GPU 서비스 비교 부록 D · 실패 없는 오픈소스 데이터셋 & 허깅페이스 리더보드 활용법 D.1 추천 오픈소스 데이터셋 카탈로그 D.2 데이터 품질 검수 도구와 방법론 D.3 허깅페이스 리더보드 완벽 활용법 D.4 합성 데이터(Synthetic Data) 생성 전략 부록 E · 유용한 도구 및 라이브러리 ? 에러 해결 Q&A E.1 SLM 개발 스택 전체 도구 목록 E.2 자주 발생하는 에러와 해결책 부록 F · 오픈소스 모델 라이선스 및 상업적 이용 법적 가이드 F.1 주요 오픈소스 AI 라이선스 깊이 이해하기 F.2 파인튜닝 시 라이선스 변경 여부 F.3 2026년 주요 법적 이슈와 주의사항 F.5 상업 서비스 출시 전 확인 항목 (체크리스트) F.6 라이선스 컴플라이언스 실전 워크플로 |
품목정보
- 발행일
- 2026년 06월 16일
- 지원기기
- 크레마, PC(윈도우 - 4K 모니터 미지원), 아이폰, 아이패드, 안드로이드폰, 안드로이드패드, 전자책단말기(저사양 기기 사용 불가), PC(Mac)
- 파일/용량
- PDF(DRM) | 8.09MB ?
- 글자 수/ 페이지 수
- 약 683쪽 ?
- ISBN13
- 9791124252734