
소개
목차
|
전체 목차
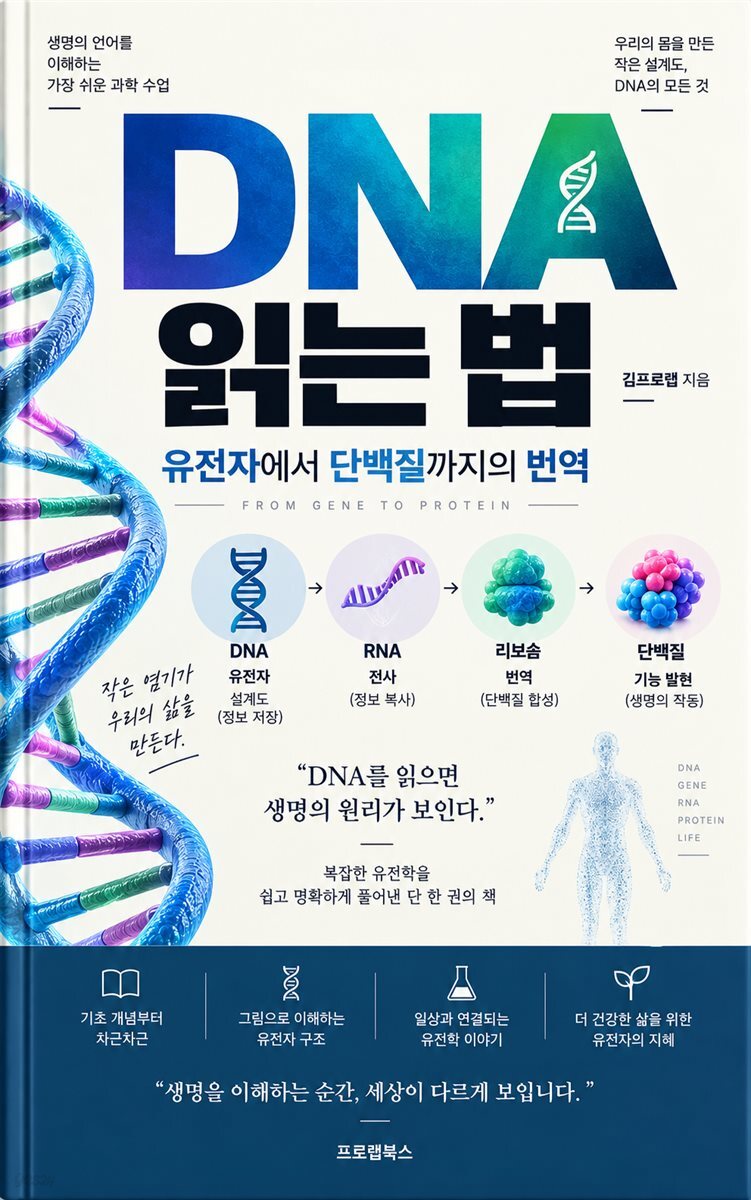
프롤로그 · 유전자는 운명을 문장으로 쓰지 않는다 1장 · 염기서열을 읽기 전에 알아야 할 문법 [1-1] 네 글자보다 먼저 봐야 할 분자의 방향 [1-2] 상보적 가닥에서 주형을 찾는 법 [1-3] 유전자와 코딩 영역은 같은 말이 아니다 [1-4] 단백질을 만들지 않는 DNA의 여러 역할 [1-5] 복제와 수선이 정보를 지키는 방식 2장 · 전사: 어떤 정보를 언제 꺼내 쓰는가 [2-1] 프로모터에서 시작되는 선택 [2-2] RNA 중합효소가 만드는 복사본 [2-3] 같은 DNA로 다른 세포가 되는 이유 [2-4] 염색질과 환경 사이의 조절 [2-5] RNA 양을 읽을 때 놓치는 시간 3장 · RNA 가공: 복사본은 곧바로 원고가 되지 않는다 [3-1] 캡과 꼬리가 바꾸는 RNA의 생애 [3-2] 스플라이싱은 무엇을 지우고 남기는가 [3-3] 하나의 유전자에서 여러 전사체가 나오는 이유 [3-4] RNA 편집과 품질 관리의 경계 [3-5] RNA 데이터에서 실제로 보이는 것 4장 · 번역: 세 글자가 아미노산이 되는 순간 [4-1] 코돈표와 읽기틀을 함께 읽는 법 [4-2] tRNA와 효소가 지키는 대응 관계 [4-3] 리보솜은 어떻게 사슬을 늘리는가 [4-4] 시작과 종결은 문맥으로 결정된다 [4-5] 유전 암호의 예외를 다루는 순서 5장 · 단백질: 만들어진 뒤에야 시작되는 기능 [5-1] 아미노산 서열에서 접힘으로 [5-2] 세포 안의 주소와 단백질의 이동 [5-3] 절단과 화학적 변형이 만드는 활성 [5-4] 단백질을 없애는 일이 필요한 이유 [5-5] 양과 구조와 기능을 구분해서 측정하기 6장 · 변이: 한 글자의 차이를 과장하지 않는 법 [6-1] 겸상적혈구 사례로 읽는 분자적 원인 [6-2] 동의 변이와 스플라이싱 변이의 함정 [6-3] 유전자 용량과 조절 영역의 변화 [6-4] 참조 서열과 검사 결과 사이의 거리 [6-5] 원인이라는 결론에 필요한 증거 7장 · 직접 읽고 검증하는 유전자 해석 [7-1] 짧은 서열을 단백질로 옮기는 연습 [7-2] DNA에서 기능까지 실험을 연결하기 [7-3] RNA와 단백질 결과가 어긋날 때 [7-4] 데이터베이스와 예측 도구를 읽는 기준 [7-5] 과학 뉴스 한 편을 검증하는 질문 에필로그 · 더 정확하게 모른다고 말할 수 있는 독자 |
저자 소개
김프로랩은 전문 지식을 독자가 사용할 수 있는 설명으로 연결하는 지식 콘텐츠 브랜드입니다.
분자생물학과 유전체학의 연구 지식을 중심으로, 전문가 집단의 집필·검토 방식을 지향합니다.
연구자의 기전 설명과 과학 교양 편집자의 독자 관점을 함께 적용해 개념의 연결을 설계합니다.
이 책에서는 용어의 정의, 실제 연구의 근거, 학습용 가정, 아직 확인되지 않은 부분을 구분하는 데 집중했습니다.
김프로랩이 추구하는 결과는 많이 외운 독자보다 관찰과 해석의 차이를 설명할 수 있는 독자입니다.
분자생물학과 유전체학의 연구 지식을 중심으로, 전문가 집단의 집필·검토 방식을 지향합니다.
연구자의 기전 설명과 과학 교양 편집자의 독자 관점을 함께 적용해 개념의 연결을 설계합니다.
이 책에서는 용어의 정의, 실제 연구의 근거, 학습용 가정, 아직 확인되지 않은 부분을 구분하는 데 집중했습니다.
김프로랩이 추구하는 결과는 많이 외운 독자보다 관찰과 해석의 차이를 설명할 수 있는 독자입니다.
품목정보
- 발행일
- 2026년 09월 22일
- 지원기기
- 크레마,PC(윈도우 - 4K 모니터 미지원),아이폰,아이패드,안드로이드폰,안드로이드패드,전자책단말기(저사양 기기 사용 불가),PC(Mac)
- 파일/용량
- EPUB(DRM) | 1.95MB ?
- ISBN13
- 9791176936286
