
소득공제
PDF
eBook
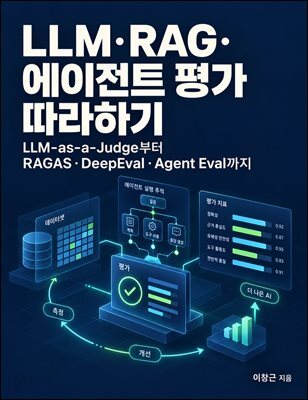
LLM·RAG·에이전트 평가 따라하기 (LLM-as-a-Judge부터 RAGAS·DeepEval·Agent Eval까지)
스마트한 PDF 필기 기능을 사용해 보세요!
- PDF 안내
-
이 상품은 구매 후 지원 기기에서 예스24 eBook앱 설치 후 바로 이용 가능한 상품입니다.
소개
목차
|
00. 이 책을 시작하기 전에
01. 생성형 AI 평가는 무엇이 다른가 01-1. 데모와 제품의 차이를 만드는 평가 01-2. 실습 환경 준비하기 01-3. 실습: 같은 질문을 열 번 던져보기 02. 전통적인 지표와 그 한계 02-1. Exact Match, F1, BLEU, ROUGE 02-2. 임베딩으로 의미 비교하기 02-3. 실습: 네 가지 지표로 같은 답변 채점하기 03. LLM-as-a-Judge 직접 만들기 03-1. LLM을 평가자로 쓴다는 것 03-2. PASS FAIL Judge와 구조화 출력 03-3. 점수와 Rubric으로 평가하기 03-4. Pairwise Judge로 두 답변 비교하기 03-5. 실습: 답변 정확성 평가기 만들기 04. Judge를 믿어도 되는가 04-1. Judge의 편향과 흔들림 04-2. 실습: 순서를 바꾸면 판정이 바뀔까 04-3. 실습: 사람의 평가와 맞춰보기 04-4. Local Judge와 Multi-Judge 04-5. 실습: Jev로 Judge 바꿔 보기 05. RAG 평가의 구조 05-1. RAG는 무엇을 평가해야 하는가 05-2. 검색 결과 평가하기 05-3. Faithfulness와 Hallucination 05-4. 실습: 평가용 RAG를 만들고 직접 채점하기 06. RAGAS로 RAG 평가하고 개선하기 06-1. RAGAS 시작하기 06-2. 검색 품질 지표 06-3. 생성 품질 지표 06-4. 평가 결과에서 실패 원인 찾기 06-5. 실습: Chunk Size와 Top-K를 평가로 정하기 06-6. 실습: 임베딩 모델과 Reranker 효과 재기 06-7. 실습: RAGAS-JEV와 RAGAS 비교하기 07. DeepEval로 LLM 테스트하기 07-1. DeepEval 시작하기 07-2. G-Eval로 나만의 평가 기준 만들기 07-3. 실습: pytest로 LLM 테스트 작성하기 07-4. 실습: DeepEval에서 Jev 쓰기 08. Agent 평가 08-1. Agent는 왜 평가가 더 어려운가 08-2. 실습: 평가할 Agent와 Trace 만들기 08-3. Task Completion과 Tool 호출 평가 08-4. Trajectory와 Plan 평가 08-5. 실습: DeepEval로 Agent 전체 평가하기 09. Evaluation Engineering 09-1. 평가 데이터셋 만들기 09-2. Regression 평가와 CI CD 09-3. Failure Taxonomy로 실패 분류하기 09-4. 품질 비용 지연을 함께 보기 09-5. Production 평가 10. 실전 프로젝트 10-1. 프로젝트 1 사내 문서 RAG 평가 시스템 10-2. 프로젝트 2 업무 Agent 평가 시스템 10-3. 프로젝트 3 자동 Evaluation Pipeline 11. 맺으며: LLM-as-a-Judge 이후의 평가 부록A 평가 지표 한눈에 보기 부록B Judge 프롬프트 템플릿 모음 부록C 평가 데이터셋 템플릿과 프로젝트 구조 부록D 평가 시스템 설계 체크리스트 |
저자 소개
연세대학교에서 기계공학 학부·석사를 마쳤습니다. SK컴즈, 싸이월드, 네이버에 근무하면서 IT 서비스를 경험했고, 넥스트랩 창업, 크라우드웍스 근무를 통해 AI를 공부하고 인사이트를 얻었습니다. 지금은 AI 에이전트와 신뢰도 기반 지능화 기술에 특히 관심을 가지고 있습니다.
품목정보
- 발행일
- 2026년 09월 28일
- 지원기기
- 크레마, PC(윈도우 - 4K 모니터 미지원), 아이폰, 아이패드, 안드로이드폰, 안드로이드패드, 전자책단말기(저사양 기기 사용 불가), PC(Mac)
- 파일/용량
- PDF(DRM) | 12.11MB ?
- 글자 수/ 페이지 수
- 약 411쪽 ?
- ISBN13
- 9791192856872
