소득공제
PDF
eBook
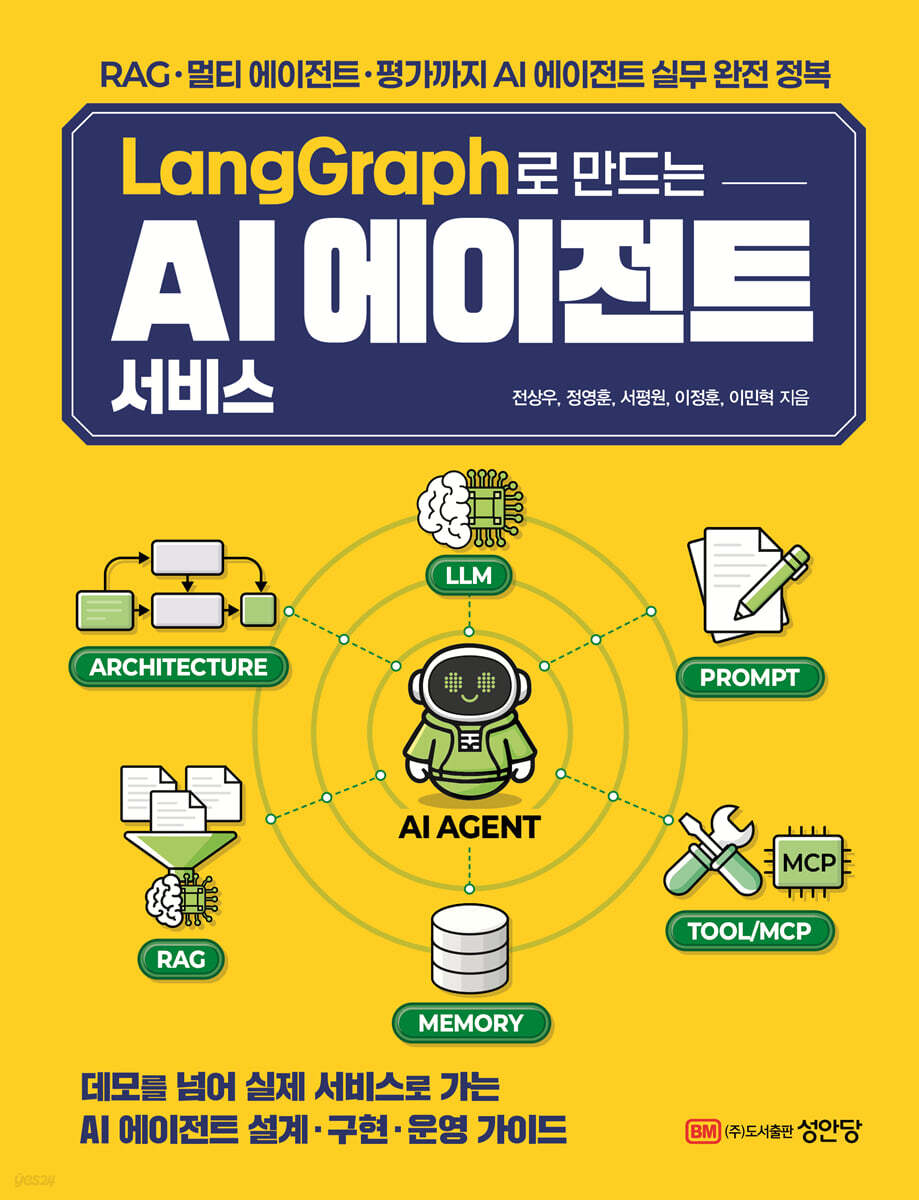
LangGraph로 만드는 AI 에이전트 서비스
스마트한 PDF 필기 기능을 사용해 보세요!
- PDF 안내
-
이 상품은 구매 후 지원 기기에서 예스24 eBook앱 설치 후 바로 이용 가능한 상품입니다.
상세 이미지

소개
목차
|
서문저자 소개추천사1부 시작하기1장 에이전트의 시대AI 에이전트의 시대1.1 생성형 AI의 발전 속도1.1-1 폭발적인 성장의 시작1.1-2 2026년, AI는 어디까지 왔는가?1.1-3 왜 발전 속도가 중요한가?1.2 AI 에이전트의 능력1.2-1 LLM의 한계1.2-2 AI 에이전트란 무엇인가?1.2-3 에이전트의 핵심 구성 요소1.2-4 생각하고, 행동하고, 관찰하기1.2-5 기존 소프트웨어와 무엇이 다른가?1.2-6 에이전트는 ‘새로운 팀원’1.3 AI 에이전트의 실생활 예시1.3-1 ChatGPT: 에이전트로의 진화1.3-2 에이전트 도입의 확산1.3-3 왜 지금 배워야 하는가?1.4 AI 에이전트 개발을 시작해 보자1.4 AI 에이전트 개발을 시작해 보자1.4-1 이 책에서 배울 것1.4-2 왜 LangChain과 LangGraph인가?핵심 정리2장 개발 시작하기개발 시작하기2.1 개발 환경 설정2.1-1 Python 설치2.1-2 패키지 관리자 사용하기2.1-3 LangChain & LangGraph 설치2.1-4 Streamlit으로 채팅 UI 만들기2.2 LLM 모델 사용 준비2.2-1 OpenAI API 키 발급2.2-2 모델 선택 가이드2.3 프로젝트 구성2.3-1 프로젝트 구조 생성2.3-2 환경 변수 및 API 키 관리2.3-3 첫 번째 에이전트 만들기2.3-4 애플리케이션 실행2.3-5 프로젝트 공유 준비핵심 정리3장 LangChain3.1 LangChain 첫걸음3.1-1 LLM 개발, 생각보다 복잡하다3.1-2 LangChain 소개3.1-3 LangChain과 커뮤니티3.1-4 LangChain 공식문서3.2 챗 모델3.2-1 Invoke 메서드로 챗 모델 호출하기3.2-2 챗 모델 활용하기3.2-3 스트리밍 호출3.2-4 다양한 모델 공급자 지원3.3 메시지3.3-1 메시지 타입3.3-2 왜 여러 유형의 메시지가 필요할까?3.3-3 SystemMessage 활용하기3.3-4 AIMessage 활용하기3.3-5 스트리밍과 MessageChunk3.4 프롬프트3.4-1 프롬프트란 무엇인가?3.4-2 왜 프롬프트가 중요한가?3.4-3 프롬프트 템플릿이 필요한 이유3.4-4 프롬프트 템플릿 사용하기3.5 러너블3.5-1 러너블이란 무엇인가?3.5-2 왜 러너블이 중요한가?3.5-3 러너블의 핵심 인터페이스3.5-4 러너블 활용 예제3.5-5 RunnableLambda3.6 러너블 설정3.6-1 RunnableConfig3.6-2 콜백3.6-3 Configurable3.7 LCEL3.7-1 LCEL 기본 문법3.7-2 함수 연결하기3.7-3 RunnableParallel3.7-4 RunnablePassthrough핵심 정리4장 프롬프트 엔지니어링프롬프트 엔지니어링4.1 프롬프트 엔지니어링 소개4.1-1 프롬프트 엔지니어링이 해결하는 문제들4.1-2 프롬프트 엔지니어링을 시작하기 전에4.1-3 프롬프트 엔지니어링은 반복적인 과정이다4.2 프롬프트 엔지니어링의 기본 원칙4.2-1 명확하고 직접적이며 상세하게4.2-2 구조화 프롬프트: XML과 Markdown 활용4.2-3 실전 예시: 구조화 프롬프트4.3 프롬프트 엔지니어링의 핵심 기법4.3-1 페르소나4.3-2 맥락 정보 제공하기4.3-3 사고 연쇄4.3-4 퓨샷 프롬프팅4.4 모델 파라미터: 프롬프트를 넘어 LLM을 제어하는 힘4.4-1 샘플링 파라미터: 출력의 다양성 제어4.4-2 출력 제어 파라미터4.4-3 반복 억제 파라미터 1164.4-4 프로덕션 환경에서의 최적화핵심 정리2부 핵심 구성 요소RAG5장 RAG5.1 LLM 모델의 한계5.1-1 정적인 학습 데이터의 한계5.1-2 지식 단절 문제5.1-3 환각 현상과의 연결5.1-4 파인튜닝의 한계5.1-5 더 나은 해결책의 필요성5.2 RAG 소개5.2-1 RAG란?5.2-2 RAG의 장점5.2-3 RAG의 핵심 구성 요소5.3 RAG 구현5.3-1 OpenSearch 소개5.3-2 OpenSearch 설치5.3-3 문서 인덱싱5.3-4 검색 및 답변 생성5.3-5 LangChain LCEL을 활용한 간편 구현5.4 Retriever 성능 개선 - Hybrid Search5.4-1 임베딩이란?5.4-2 검색 방식의 종류5.4-3 하이브리드 검색 구현5.4-4 가중치 튜닝핵심 정리메모리6장 메모리6.1 메모리란?6.1-1 메모리가 없을 때6.1-2 메모리가 있을 때6.1-3 LLM은 왜 기억을 못할까?6.2 메모리 전략6.2-1 전체 저장(Full History)6.2-2 최근 N개만 저장(Window)6.2-3 요약 저장(Summary)6.2-4 전략 비교6.3 전체 대화 저장하기6.3-1 기본 구현6.3-2 동작 원리6.3-3 대화 기록 확인하기6.3-4 session_id의 중요성6.4 최근 대화만 저장하기6.4-1 메시지 자르기 구현6.4-2 trim_messages 옵션6.4-3 토큰 기반 자르기6.5 대화 요약하기6.5-1 요약 메모리 구현6.5-2 동작 원리6.5-3 다양한 저장소 활용하기핵심 정리7장 메모리도구와 MCP7.1 도구와 MCP 개요7.1-1 LLM과 도구의 역할 분담7.1-2 도구의 개념과 구조 1767.1-3 LangChain에서의 도구 정의 방식7.2 MCP 프로토콜 이해하기7.2-1 MCP의 아키텍처7.2-2 도구 발견과 호출: tools/list, tools/call7.2-3 오류 처리7.2-4 MCP와 LangChain 통합7.2-5 MCP 도입 시 고려사항핵심 정리구조화된8장 구조화된 출력출력8.1 구조화된 출력이란?8.1-1 자유 텍스트 응답의 문제8.1-2 약속된 형식으로 응답받기8.1-3 구조화된 출력이 없을 때8.1-4 구조화된 출력이 있을 때8.1-5 핵심 장점8.2 Pydantic 스키마 기초8.2-1 Pydantic이란?8.2-2 BaseModel로 스키마 정의하기8.2-3 Field로 상세 설명 추가하기8.2-4 타입 힌트의 중요성8.2-5 완성된 스키마 예제8.2-6 스키마 설계 원칙8.3 LangChain에서 구조화된 출력 사용하기8.3-1 with_structured_output 메서드3-2 기본 사용법8.3-3 반환 값은 Pydantic 객체8.3-4 동작 원리8.3-5 프롬프트와 함께 사용하기8.4 method 옵션 이해하기8.4-1 세 가지 method 옵션8.4-2 json_schema (기본값)8.4-3 function_calling8.4-4 json_mode8.4-5 method 선택 가이드8.4-6 코드 예제8.4-7 strict 옵션8.4-8 include_raw 옵션8.5 실전 활용8.5-1 여러 휴가 신청 한 번에 처리하기8.5-2 선택지 제한하기8.5-3 선택적 필드 처리하기핵심 정리3부 에이전트 구축9장 에이전트 구축LangGraph9.1 LangGraph란?9.1-1 왜 LangGraph인가?9.1-2 LangGraph의 핵심 아이디어9.1-3 LCEL vs. LangGraph9.2 StateGraph의 기본 구조9.2-1 State: 그래프의 메모리9.2-2 Node: 작업 수행자9.2-3 Edge: 연결 경로9.2-4 첫 번째 그래프 만들기9.3 노드와 엣지 추가하기9.3-1 노드 등록하기9.3-2 순차 연결9.3-3 조건부 분기9.3-4 HR 요청 분류 에이전트9.3-5 루프9.3-6 병렬 실행9.3-7 Subgraph9.3-8 동적 라우팅9.4 그래프 실행하기9.4-1 컴파일9.4-2 동기 실행(invoke)9.4-3 스트리밍 실행9.4-4 실행 흐름 디버깅9.5 영속성과 체크포인트9.5-1 왜 영속성이 필요한가?9.5-2 InMemorySaver 사용하기9.5-3 세션 관리 (thread_id)9.5-4 휴먼 인 더 루프핵심 정리10장 단일 에이전트 설계단일 에이전트 설계10.1 서비스 요구에서 단일 에이전트 설계까지10.1-1 기능 요구를 에이전트 문제로 바꾸기10.1-2 입력·출력·품질 기준으로 다시 쓰기10.2 단일 에이전트 아키텍처의 기본 구조10.2-1 한 화면·한 엔드포인트·한 에이전트10.2-2 입력 파싱·검증 레이어10.2-3 LLM + RAG + 도구 호출 레이어10.2-4 후처리·포맷팅 레이어10.2-5 관측 가능성·오류 처리 레이어10.3 단일 에이전트를 위한 선형 워크플로우 패턴10.3-1 왜 ‘선형 워크플로우’로 보는가?10.3-2 패턴 A: 기본 순차형 워크플로우10.3-3 패턴 B: 의도 분기형 워크플로우10.3-4 패턴 C: 병렬 도구 호출 워크플로우10.3-5 패턴 D: 툴 퍼스트 워크플로우10.3-6 패턴 선택을 위한 간단한 체크리스트10.4 에이전틱 워크플로우와 LangChain ReAct 에이전트10.4-1 선형 워크플로우에 ‘선택과 반복’ 더하기10.4-2 ReAct 패턴: 생각과 행동의 반복10.4-3 create_agent로 ReAct 에이전트 만들기10.4-4 단일 에이전트에서 에이전틱 워크플로우를 어디까지 쓸까?10.5 실습 선형 워크플로우 + ReAct 에이전트 + 휴먼 인 더 루프10.5-1 시나리오: 교육비 지원 신청 에이전트10.5-2 도구 정의하기: 선형 워크플로우를 잘게 나누기10.5-3 휴먼 인 더 루프 미들웨어로 승인 단계 추가하기10.5-4 간단한 CLI 루프로 에이전트 실행해 보기10.5-5 선형 워크플로우의 패턴과 휴먼 인 더 루프를 어떻게 조합했는가?10.6 단일 에이전트의 한계 신호 읽기10.6-1 단일 에이전트가 한계에 다다랐다는 신호들10.6-2 단일 에이전트에서 확장해 나갈 때 확인할 것들핵심 정리11장 멀티 에이전트 멀티 에이전트11.1 단일 에이전트를 넘어서는 문제들11.1-1 단일 에이전트 복잡도를 보는 네 가지 축11.1-2 멀티 에이전트를 고려해야 하는 시점11.1-3 멀티 에이전트의 장단점: 구조·운영·서비스 관점에서 보기11.2 멀티 에이전트 구조의 구성 요소11.2-1 역할 중심 에이전트 정의11.2-2 상태 중심 설계11.2-3 상위 그래프와 서브그래프11.3 주요 멀티 에이전트 패턴11.3-1 라우터-전문가 패턴11.3-2 검증자·가드레일 패턴11.3-3 기타 패턴11.4 실습 예제 LangGraph로 멀티 에이전트 그래프 설계·구현하기11.4-1 예제 구조 한눈에 보기11.4-2 도메인별 단일 에이전트 만들기(create_agent)11.4-3 create_supervisor로 라우터-전문가 패턴 구현하기11.4-4 수동 StateGraph 설계와 Supervisor 패턴 비교11.5 도메인 예제 HR 상담 서비스에 멀티에이전트 적용하기11.5-1 전체 구조 한눈에 보기11.5-2 에이전트별 설계 포인트11.5-3 운영 중 구조를 진화시키기11.5-4 멀티 에이전트 설계 시 스스로에게 던질 질문핵심 정리4부 프로덕션 운영12장 관측 가능성관측 가능성12.1 에이전트 관측 가능성12.1-1 에이전트 운영의 출발점12.1-2 우리가 다루는 관측 가능성의 영역12.1-3 에이전트 관찰의 단위12.1-4 관찰을 이루는 세 가지 축12.1-5 실전 도구와 12장의 흐름12.2 로그와 지표12.2-1 에이전트 실행 로그의 계층 구조12.2-2 단위별 필수 로그 필드12.2-3 관찰 도구와 애플리케이션 로그의 역할 분담12.2-4 기본 지표 설계12.2-5 단위별 지표12.2-6 운영 전략12.3 흐름 추적12.3-1 로그와 지표 사이를 잇는 퍼즐 조각12.3-2 에이전트 실행을 흐름으로 그려 보기12.3-3 Langfuse 설치 및 설정12.3-4 Langfuse의 흐름 추적 모델: Trace와 Observation12.3-5 LangGraph + LangChain + Langfuse 연동 예시12.3-6 흐름 추적을 운영에 활용하는 방법12.4 관측 가능성을 활용한 운영 흐름12.4-1 질문에서 출발하는 운영 흐름12.4-2 자주 마주치는 세 가지 상황핵심 정리13장 평가와 품질 관리평가와 품질 관리13.1 RAG 평가 지표13.1-1 검색기 평가13.1-2 Generator 평가13.1-3 End-to-End 평가13.1-4 평가 지표 선택 가이드13.2 평가 도구와 자동화13.2-1 Langfuse로 평가 점수 기록13.2-2 RAGAS로 자동 평가13.2-3 Langfuse와 RAGAS 통합13.3 LLM 평가와 로직 기반 평가13.3-1 LLM-as-a-judge란?13.3-2 LLM 평가 구현13.3-3 로직 기반 평가(Structured Output 검증)13.3-4 CI/CD 파이프라인에 통합13.3-5 평가 방법 선택 가이드13.4 Reasoning 디버깅 실패 원인 추적하기13.4-1 최종 답변만으로는 원인을 알 수 없다13.4-2 에이전트의 실행 단계 이해하기13.4-3 content_blocks로 모델의 사고 과정 들여다보기핵심 정리14장 성능 & 비용 최적화능 & 비용 최적화14.1 왜 최적화가 필요한가?14.1-1 생성형 AI 서비스가 다른 이유14.4-2 비용 계산해 보기14.1-3 속도 문제14.1-4 최적화의 세 가지 축14.2 측정 최적화의 시작점14.2-1 무엇을 측정해야 하는가?14.2-2 워터폴 분석14.2-3 Langfuse에서 병목 찾기14.2-4 비용 측정14.2-5 측정 후 우선순위 정하기14.3 병렬 처리 속도의 핵심14.3-1 순차 실행의 문제14.3-2 병렬 실행의 효과14.3-3 LangGraph로 병렬 처리 구현14.3-4 배치 처리14.3-5 병렬 처리 시 주의사항14.3-6 실전 패턴: 검색 + 검증 병렬화14.4 추론 강도 조절14.4-1 Reasoning Effort란?14.4-2 분류기 기반 라우팅14.4-3 계단식 호출(Cascading)14.4-4 LangGraph로 라우팅 구현14.4-5 Fallback 패턴14.4-6 라우팅 시 주의사항14.5 프롬프트 & 토큰 최적화14.5-1 프롬프트 압축14.5-2 출력 길이 제한14.5-3 대화 요약으로 컨텍스트 절감14.5-4 컨텍스트 필터링14.5-5 토큰 수 추정핵심 정리15장 신뢰성과 에러 처리뢰성과 에러 처리15.1 AI 에이전트의 실패 이해하기15.1-1 오류와 장애15.1-2 재시도할 수 있는 오류15.1-3 핵심 패턴15.2 오류 처리 재시도와 폴백15.2-1 Tenacity로 똑똑한 재시도15.2-2 LangChain 네이티브 재시도15.2-3 Fallback으로 오류 우회핵심 정리안전한 에이전트 개발16.1 여기까지 오며 만든 것들16.1-1 에이전트가 예상대로만 동작할까?16.1-2 전통적인 코드 vs. AI 에이전트 16.1-3 16장에서 배울 것16.1-4 가드레일이 필요한 순간들16.2 시스템 프롬프트 보호하기16.2-1 시스템 프롬프트는 왜 중요할까?16.2-2 시스템 프롬프트 노출 시도 유형16.2-3 방어 전략 1 프롬프트에 보호 규칙 추가16.2-4 방어 전략 2 입력 검증 (코드 레벨)16.2-5 방어 전략 3 민감 정보 분리16.2-6 에이전트에 통합하기16.3 입력 가드레일16.3-1 입력 가드레일이란?16.3-2 민감 정보 마스킹16.3-3 유해 콘텐츠 필터링16.3-4 계층화된 입력 가드레일16.3-5 에이전트에 적용하기16.4 출력 가드레일16.4-1 왜 출력도 검증해야 할까?16.4-2 출력 가드레일의 역할16.4-3 금지 키워드 필터16.4-4 민감 정보 마스킹16.4-5 시스템 프롬프트 유출 탐지16.4-6 통합 출력 가드레일16.4-7 전체 파이프라인16.5 에이전트 권한 제어16.5-1 과도한 권한 부여의 위험16.5-2 구현 예제핵심 정리
|
저자 소개 5
『LangGraph로 만드는 AI 에이전트 서비스』를 집필했고, 장난기 가득한 이안이의 아빠이자 AI 에이전트를 만드는 개발자입니다. 인터넷 기업에서 대규모 백엔드 시스템을 다루었고, 지금은 금융 분야에 AI 기술을 접목하는 일을 하고 있습니다. AI 도구를 매일 쓰다 보니 어느새 코드를 짜는 방식뿐 아니라 하루를 보내는 방식까지 달라졌습니다. 이 책이 AI 활용에 첫걸음을 내딛는 분들게 든든한 길잡이가 되길 바랍니다.
대규모 IT 서비스 기업에서 백엔드 개발을 해 왔고, 현재는 금융권에서 LLM 기반 시스템 설계부터 개발, 운영까지 맡고 있습니다. 복잡한 문제를 구조화해 흐름으로 정리하는 일을 좋아합니다. 사용자의 관점에서 문제를 다시 정의하고, 그 관점이 구현으로 이어지게 만드는 데 집중합니다.
AI에 흥미를 느껴 개발자가 되었습니다. 인공지능 엔지니어(AI Engineer)로 시작해서 지금은 백엔드 엔지니어(Backend Engineer)로 근무하고 있습니다. 빠르게 발전하는 AI와 에이전트 소식에 관심이 많으며 다가올 미래에 대해 이야기하는 걸 좋아합니다.
파이썬을 좋아하는 AI 서비스 개발자입니다. 파이썬의 명료함과 AI의 강력함을 결합해 서비스를 만들어가는 일에 푹 빠져 있습니다. 업무 외에는 자전거와 책상 꾸미기에 관심이 있습니다.
금융권에서 AI 에이전트 서비스를 만드는 개발자입니다. 『LangGraph로 만드는 AI 에이전트 서비스』를 함께 집필했고, 요즘은 업무 시간 대부분을 Claude Code와 함께 작업하며 보냅니다. 이 책의 2부와 3부에는 직접 도구를 만들고 운영하며 얻은 경험을 담았습니다. AI가 만든 결과를 사람이 확인하는 습관이 더 널리 자리 잡기를 바랍니다. AI와 암벽 등반을 좋아합니다.
품목정보
- 발행일
- 2026년 04월 28일
- 이용안내
-
- 배송 없이 구매 후 바로 읽기
- 이용기간 제한없음
- TTS 불가능
- 저작권 보호를 위해 인쇄 기능 제공 안함
- 지원기기
- 크레마, PC(윈도우 - 4K 모니터 미지원), 아이폰, 아이패드, 안드로이드폰, 안드로이드패드, 전자책단말기(저사양 기기 사용 불가), PC(Mac)
- 파일/용량
- PDF(DRM) | 30.60MB ?
- 글자 수/ 페이지 수
- 약 443쪽 ?
- ISBN13
- 9788931590272