
- 판매자
-
오늘의책방
중고샵 판매자가 직접 등록/판매하는 상품으로 판매자가 해당 상품과 내용에 모든 책임을 집니다.
이미 소장하고 있다면 판매해 보세요.
- 한정판매의 특성상 재고 상황에 따라 품절 가능
중고도서 소개
|
책소개
목차
|
들어가기
역자 서문 감사의 글 제2판 서언 제1판 서언 제1부 사전주제 제1장 서문 1.1 데이터마이닝이란? 1.2 데이터마이닝은 어디에 쓰이는가? 1.3 데이터마이닝의 기원 1.4 데이터마이닝의 빠른 성장 1.5 왜 이렇게 많은 다른 방법들이 있는가? 1.6 용어와 표기법 1.7 로드맵 제2장 데이터마이닝 프로세스 개요 2.1 서론 2.2 데이터마이닝의 핵심 아이디어 2.3 지도학습과 비지도학습 2.4 데이터마이닝 단계 2.5 데이터분석 사전 단계 2.6 모델 구축: 선형 회귀분석을 이용한 예제 2.7 엑셀을 이용한 데이터마이닝 연습문제 제2부 데이터탐색 및 차원축소 제3장 데이터 시각화 3.1 데이터 시각화의 사용 3.2 예제 데이터 3.3 기본 차트: 막대차트, 선 그래프, 산점도 3.4 다차원적 시각화 3.5 특화된 시각화 3.6 시각화와 운영에 대한 요약(데이터마이닝 목적 기준) 연습문제 제4장 차원축소 4.1 서론 4.2 실질적인 고려사항 4.3 데이터 요약 4.4 상관분석 4.5 범주형 변수의 범주 개수 축소 4.6 범주형 변수에서 수치형 변수로의 변환 4.7 주성분 분석 4.8 회귀모형을 사용한 차원축소 4.9 분류와 회귀나무를 이용한 차원축소 연습문제 제3부 성능평가 제5장 분류와 예측성능의 평가 5.1 서론 5.2 분류성능의 평가 5.3 예측성능의 평가 연습문제 제4부 예측 및 분류 방법 제6장 다중 선형 회귀분석 6.1 서론 6.2 설명모델과 예측모델의 모델링 6.3 회귀식의 추정과 예측 6.4 선형 회귀분석의 변수 선택 연습문제 제7장 k-근접 이웃 기법 7.1 k-NN 분류기(범주형 결과) 7.2 k-NN 예측기(수치형 결과) 7.3 k-NN 알고리즘의 장점과 단점 연습문제 제8장 나이브 베이즈 8.1 서론 8.2 완전한(정확한) 베이지안 분류기의 적용 8.3 나이브 베이즈 분류기의 장점과 단점 연습문제 제9장 분류 회귀 나무 9.1 서론 9.2 분류나무 9.3 불순도 측정 9.4 분류나무의 성능 평가 9.5 과적합 방지하기 9.6 분류나무 모델에서의 분류 규칙 9.7 세 개 이상의 클래스를 분류하기 9.8 회귀나무 모델 9.9 모델의 장단점 및 추가사항 연습문제 제10장 로지스틱 회귀분석 10.1 서론 10.2 로지스틱 회귀모형 10.3 분류 성능 평가 10.4 분석 예제: 항공기 연착 예측 10.5 부록: 로지스틱 회귀 프로파일링 연습문제 제11장 신경망 11.1 서론 11.2 신경망의 개념과 구조 11.3 데이터에 망 적합 11.4 요구되는 사용자 입력 11.5 예측기들과 응답 사이의 관계탐색 11.6 신경망의 장점과 단점 연습문제 제12장 판별분석 12.1 서론 12.2 클래스로부터 관측치에 이르는 거리 12.3 피셔의 선형 분류함수 12.4 판별분석의 분류성능 12.5 사전확률 12.6 서로 다른 오분류 비용 12.7 세 클래스 이상일 경우의 분류 12.8 판별분석의 장단점 연습문제 제5부 레코드들 간의 관계 마이닝 제13장 연관 규칙 13.1 서론 13.2 거래 데이터베이스에서 연관규칙의 발견 13.3 후보규칙의 생성 13.4 강한 규칙의 선택 13.5 요약 연습문제 제14장 군집분석 14.1 서론 14.2 두 레코드 사이의 거리 측정 14.3 두 군집 간 거리 측정 14.4 계층적(응집) 군집화 14.5 비계층적 군집화: k-평균 군집화 방법 연습문제 제6부 시계열 예측 제15장 시계열 데이터 분석 15.1 서론 15.2 탐색 vs. 예측 모델 15.3 비즈니스에서 주로 사용되는 예측기법 15.4 시계열 요소 15.5 데이터 분할 연습문제 제16장 회귀분석을 기반으로 한 예측 16.1 추세를 반영한 모델 16.2 계절성 반영 모델 16.3 추세와 계절성을 반영한 모델 16.4 자기상관과 ARIMA모델 연습문제 제17장 평활법 17.1 서론 17.2 이동평균법 17.3 단순지수평활법 17.4 고급지수평활법 연습문제 제7부 사례 제18장 사례 18.1 찰스북클럽 사례 18.2 독일 신용 은행 사례 18.3 테이코 소프트웨어 카탈로그 판매회사 사례 18.4 목욕비누 구매자 세분화 사례 18.5 직접우편을 통한 기금모금 사례 18.6 카탈로그 교차 판매 사례 18.7 파산 예측 사례 18.8 시계열 예측: 대중교통 수요 예측 참고문헌 찾아보기 |
저자 소개
저자소개
Galit Shmueli
메릴랜드대학교 스미스경영대학의 eMarkets Research Lab 디렉터이자 통계학과 부교수이다. Statistical Methods in e-Commerce Research와 Modeling Online Auctions의 공저자이다.
Nitin R. Patel
매사추세츠 주 케임브리지에 위치한 Cytel, Inc.의 공동창립자이자 의장이다. 미국통계학회의 회원이자 MIT에서 10년 이상 초빙교수로 재직했다.
Peter C. Bruce
통계분석가들에게 통계학 관련 전문 개발과정의 온라인리소스를 제공하는 Statistics.com의 소유주이자 회장이다.
역자소개
조재희_ 광운대학교 경영학부 교수
네브래스카대학교에서 의사결정지원시스템 연구로 박사학위를 취득하였고, 펜타시스템테크놀로지와 STM(구 LG CNS)에서 책임컨설턴트로 재직하며 LG산전, 동양화재, 유공 등 국내기업의 데이터웨어하우스 개발에 참여하였다. 현재 광운대학교 경영학부 교수로 재직하고 있으며, 창업지원센터장, 입학처장, 국제처장을 역임하였다. 주요 관심분야는 데이터자산의 전략적 활용, 시공간 데이터분석, 다차원모델링 등이며, 현재 한국BI데이터마이닝학회장을 맡고 있다.
조성배_ 연세대학교 컴퓨터과학과 교수
패턴인식과 인공지능 분야에서 실제문제 해결을 통해?SCI등재 논문지에 200여 편을 포함한 1,000편가량의 논문을 발표하였다. 다수의 국내외 논문지의 편집위원을 맡고 있으며, IEEE 주관의 여러 학술대회 위원장을 역임하였다. 인간의 추론학습 기능을 모방한 정보 마이닝 기술에 기반하여 모바일 환경에서의 상황인식 및 개인화 서비스 개발에 관심이 있다. KAIST에서 신경망의 현실적인 적용방안 연구로 박사학위를 받고, 일본 ATR 인간정보통신연구소 등의 연구원으로 재임하였다.
이성임_ 단국대학교 정보통계학과 교수
서울대학교 통계학과에서 생존분석을 주제로 박사학위를 취득하고, 서울대학교 복잡계통계연구소의 박사후연구원과 고려대학교 의과학연구원에서 연구교수를 지냈다. 현재 단국대학교 정보통계학과 부교수로 재직 중이고 최근 데이타마이닝과 품질관리에 관심을 갖고 연구하고 있다.
신현정_ 아주대학교 산업공학과 교수
서울대학교에서 산업공학박사학위를 받고 독일 막스플랑크연구소(Max-Planck-Institute)에서 연구원으로 재직하였다. 귀국 후 서울대학교 의과대학 연구교수로 재임하였으며, 이후 아주대학교 산업공학과에 부임하여 현재 부교수로 재직 중이다. 주된 관심 연구분야는 기계학습과 데이터마이닝이론으로 국내외 관련 학회 및 학술지에 많은 연구들을 기고하였다. 응용분야로는 바이오/메디컬인포매틱스 및 경제/금융시계열분야로서, 서울대학교 의과대학, 국민건강보험심사평가원, 에너지경제연구원 등의 기관들과 다수의 프로젝트를 수행하고 있다.
김성범_ 고려대학교 산업경영공학부 교수
조지아공대(Georgia Institute of Technology)에서 산업공학과 박사학위를 취득하고 미국 텍사스주립대학(University of Texas at Arlington) 산업공학과에서 교수를 역임한 후 현재는 고려대학교 산업경영공학부 부교수로 재직하고 있다. 데이터마이닝 이론과 응용분야에 80여 편의 논문을 발표하였으며 국내외 학회 및 세미나에서 다수의 연구결과를 발표하였다. INFORMS학회 데이터마이닝 부분 회장을 역임하는 등 국내외 데이터마이닝 관련 학회에서 활발한 활동을 하고 있다.
감수 : 조성준
서울대학교 산업공학과 교수. 《International Journal of Cognitive Biometrics》 및 《Samsung SDS Journal of IT Services》 편집위원을 맡고 있고, 한국BI데이터마이닝학회 회장을 역임하였다. 마케팅, 제조, 금융 및 생체보안 분야에서 데이터마이닝을 연구하여 국내외 논문 150여 편 및 다수의 특허와 상용 SW를 개발하였다. 삼성전자, 현대자동차, SK텔레콤, 포스코, 대우조선해양, 현대중공업, CJ제일제당, LG전자, 삼성카드 등과 관련 분야의 연구과제 및 자문을 수행하였다. 메릴랜드대학교에서 기계학습 및 브레인 모델링 연구로 박사학위를 받았다.
품목정보
- 발행일
- 2012년 06월 18일
- 쪽수, 무게, 크기
- 480쪽 | 190*250*30mm
- ISBN13
- 9788994246222
출판사 리뷰
|
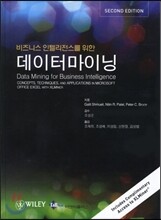
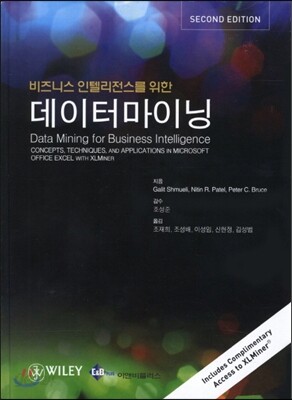
『비즈니스 인텔리전스를 위한 데이터마이닝』 제2판에서는 제1판에 이어 주요 데이터마이닝 기법들이 통찰력을 가지고 상세하게 소개될 뿐만 아니라 몇 가지 새로운 사항들이 추가되었다.
우선, 제2판에서는 데이터마이너에게 나침반과 같은 역할을 하는 데이터 시각화와 기업에서 가장 많이 사용하는 시계열 예측이 추가되면서 내용이 더욱 알차게 되었다. 둘째, 마이크로소프트 오피스 엑셀과 연동되는 XLMiner를 통하여 예측 모델과 데이터에 숨어 있는 패턴을 기술하고 발견하는 기법들을 소개했다. 제2판에서는 실제 데이터 세트가 여러 개 제공될 뿐만 아니라 무엇보다도 학생들이 비용 부담 없이 사용할 수 있는 상용 소프트웨어 XLMiner의 6개월 사용권이 제공된다. 데이터마이닝은 이론 공부만으로는 충분하지 않고, 모델링 실습과 실제 문제 해결 과정이 반드시 수반되어야 하므로 이는 커다란 장점이다. 셋째, k-NN과 나이브 베이즈 방법을 별도의 장으로 다루었다. 넷째, 각 장 맨 앞에 간단한 요약을 추가하였고, 맨 뒤에는 연습문제가 있어서 독자들은 문제를 풀어보면서 자신이 기법들을 얼마나 이해하는지 평가할 수 있다. 또한 마지막 장에는 다양한 데이터마이닝 기법들을 사용해야 하는 여러 가지 사례가 소개되어 있다. 다섯째, 몇몇 장의 순서를 재배치하고 일곱 개 부로 나눔으로써 강사가 다양한 종류의 강좌를 위해 다양한 토픽을 취사선택하기 용이하도록 했다. |
상품정보안내
- 주문 전 중고상품의 정확한 상태 및 재고 문의는 [판매자에게 문의하기]를 통해 문의해 주세요.
- 주문완료 후 중고상품의 취소 및 반품은 판매자와 별도 협의 후 진행 가능합니다. 마이페이지 > 주문내역 > 주문상세 > 판매자 정보보기 > 연락처로 문의해 주세요.
부적합 상품 신고하기
신고하기- 구매에 부적합한 상품은 신고해주세요.
- 구매하신 상품의 상태, 배송, 취소 및 반품 문의는 판매자 묻고 답하기를 이용해주세요.
- 상품정보 부정확(카테고리 오등록/상품오등록/상품정보 오등록/기타 허위등록) 부적합 상품(청소년 유해물품/기타 법규위반 상품)
- 전자상거래에 어긋나는 판매사례: 직거래 유도
24,840원
총 1개
24,840원
