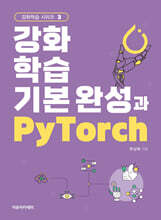

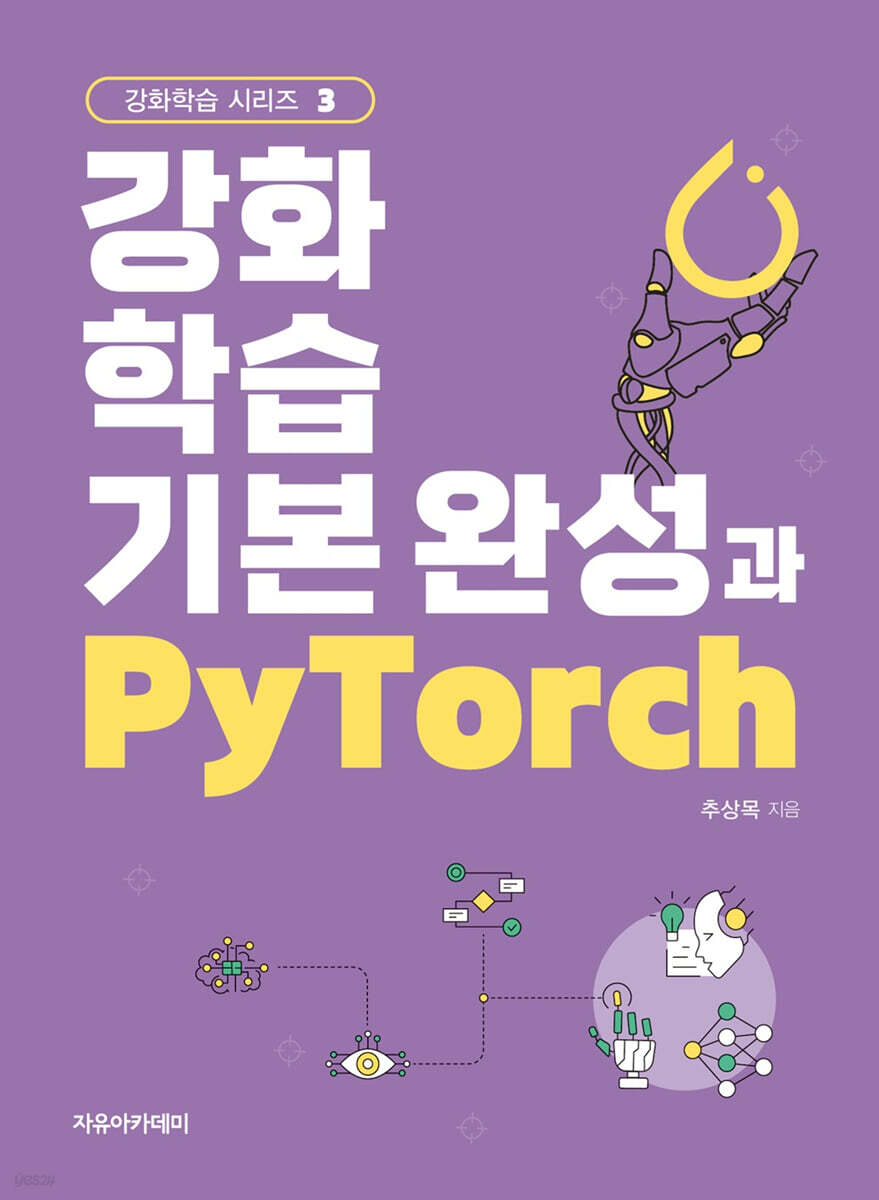
- 판매자
-
사업자
stayy5
중고샵 판매자가 직접 등록/판매하는 상품으로 판매자가 해당 상품과 내용에 모든 책임을 집니다.
이미 소장하고 있다면 판매해 보세요.
- 한정판매의 특성상 재고 상황에 따라 품절 가능
중고도서 소개
|
책소개
목차
|
제1장 REINFORCE-Monte Carlo Policy Gradient
1.용어 설명과 구성 요소 2.신경망 구조 3.정책(상태를 입력하면 행동 출력) 정의 4.학습데이터 정의 5.손실 정의 6.파라미터 업데이트 함수 7.Main 8.코드 설명 9.전체 코드 10.부록 제2장 REINFORCE-Baseline 1.용어 설명과 구성 요소 2.신경망 구조 3.정책(상태를 입력하면 행동 출력) 정의 4.학습데이터 정의 5.손실 정의 6.파라미터 업데이트 함수 7.Main 8.코드 설명 9.전체 코드 10.부록 제3장 Advantage Actor Critic(A2C) 1.용어 설명과 구성 요소 2.신경망 구조 3.정책(상태를 입력하면 행동 출력) 정의 4.학습데이터 정의 5.손실 정의 6.Main 7.전체 코드 8.부록 제4장 Asynchronous Advantage Actor Critic(A3C) 1.용어 설명과 구성 요소 2.신경망 구조 3.정책(상태를 입력하면 행동 출력) 정의 4.학습데이터 정의 5.손실 정의 6.train 함수 7.Main 8.코드 설명 9.전체 코드 10.부록 제5장 Deep Deterministic Policy Gradient(DDPG) 1.용어 설명과 구성 요소 2.신경망 구조 3.정책(상태를 입력하면 행동 출력) 정의와 노이즈 추가 4.학습데이터(replay memory) 정의 5.손실 정의 6.Main 7.코드 설명 8.전체 코드 9.부록 제6장 Twin Delayed Deep Deterministic Policy Gradient(TD3) 1.용어 설명과 구성 요소 2.신경망 구조 3.정책(상태를 입력하면 행동 출력) 정의와 노이즈 추가 4.학습데이터(replay memory) 정의 5.손실 정의 6.Main 7.전체 코드 8.부록 제7장 Trust Region Policy Optimization(TRPO) 1.용어 설명과 구성 요소 2.신경망 구조 3.정책(상태를 입력하면 행동 출력) 정의 4.학습데이터(replay memory) 정의 5.Critic 손실 정의와 actor 파라미터 업데이트 공식 6.Main 7.코드 설명 8.전체 코드 9.부록 제8장 Proximal Policy Optimization(PPO) 1.용어 설명과 구성 요소 2.신경망 구조 3.정책(상태를 입력하면 행동 출력) 정의 4.학습데이터(replay memory) 정의 5.손실 정의 6.Main 7.코드 설명 8.전체 코드 9.부록 제9장 Soft Actor Critic(SAC) 1.용어 설명과 구성 요소 2.신경망 구조 3.정책(상태가 입력되면 행동 출력) 정의 4.학습데이터(replay memory) 정의 5.손실 정의 6.Main(train 함수) 7.전체 코드 8.부록 |
저자 소개 1
서울대학교에서 이학사, 이학석사, 이학박사를 취득한 후 울산대학교 수학과에 부임하였다. 현재까지 교수로 재임하면서 대규모 데이터에서 유용한 정보를 찾는 빅데이터 분석, 신경망의 기본인 순방향신경망, 언어 처리를 위한 순환신경망, 이미지 처리를 위한 합성곱신경망, 시행착오를 통해 최적의 행동을 학습하는 강화학습, attention을 이용하여 입력과 출력의 관계를 학습하는 트랜스포머, 전문가의 행동을 관찰하여 행동 전략을 학습하는 모방학습 등을 강의하고 있다. 집필한 저서는 다음과 같다.
신경망 학습이론과 PyTorch / 순환신경망과 PyTorch
합성곱신경망과 PyTorc
서울대학교에서 이학사, 이학석사, 이학박사를 취득한 후 울산대학교 수학과에 부임하였다. 현재까지 교수로 재임하면서 대규모 데이터에서 유용한 정보를 찾는 빅데이터 분석, 신경망의 기본인 순방향신경망, 언어 처리를 위한 순환신경망, 이미지 처리를 위한 합성곱신경망, 시행착오를 통해 최적의 행동을 학습하는 강화학습, attention을 이용하여 입력과 출력의 관계를 학습하는 트랜스포머, 전문가의 행동을 관찰하여 행동 전략을 학습하는 모방학습 등을 강의하고 있다. 집필한 저서는 다음과 같다.
신경망 학습이론과 PyTorch / 순환신경망과 PyTorch
합성곱신경망과 PyTorch / 강화학습 기본과 PyTorch*
강화학습 기본 다지기와 PyTorch / 강화학습 기본 완성과 PyTorch
*: 2024 세종도서 학술부문 선정도서
신경망 학습이론과 PyTorch / 순환신경망과 PyTorch
합성곱신경망과 PyTorch / 강화학습 기본과 PyTorch*
강화학습 기본 다지기와 PyTorch / 강화학습 기본 완성과 PyTorch
*: 2024 세종도서 학술부문 선정도서
관련 분류
- 카테고리 분류
품목정보
- 발행일
- 2025년 12월 15일
- 쪽수, 무게, 크기
- 252쪽 | 188*257*12mm
- ISBN13
- 9791158087890
상품정보안내
- 주문 전 중고상품의 정확한 상태 및 재고 문의는 [판매자에게 문의하기]를 통해 문의해 주세요.
- 주문완료 후 중고상품의 취소 및 반품은 판매자와 별도 협의 후 진행 가능합니다. 마이페이지 > 주문내역 > 주문상세 > 판매자 정보보기 > 연락처로 문의해 주세요.
판매자 정보
- 업체명
- 오제웅
- 대표자명
- 오제웅
- 사업자 등록번호
- 398-51-00030
- 사업자 종목
- 서점
- 고객 상담 전화번호(유선)
- 062-375-5084
- 고객 상담 이메일
- stayy5@gmail.com
- 배송 방법
- 타사택배(CJ대한통운)
- 본사 소재지
- 광주광역시 서구 풍암동 802-1 CU 뒤편 스테이 책터
- 발송지 주소
- 광주광역시 서구 내방동 842-12 금성빌딩 201호
- 반품지 주소
- 광주광역시 서구 내방동 842-12 금성빌딩 201호
부적합 상품 신고하기
신고하기- 구매에 부적합한 상품은 신고해주세요.
- 구매하신 상품의 상태, 배송, 취소 및 반품 문의는 판매자 묻고 답하기를 이용해주세요.
- 상품정보 부정확(카테고리 오등록/상품오등록/상품정보 오등록/기타 허위등록) 부적합 상품(청소년 유해물품/기타 법규위반 상품)
- 전자상거래에 어긋나는 판매사례: 직거래 유도
23,000원
총 1개
23,000원
