- 판매자
-
악어친구들
중고샵 판매자가 직접 등록/판매하는 상품으로 판매자가 해당 상품과 내용에 모든 책임을 집니다.
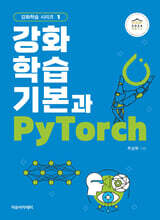
- 2024년 세종도서 학술 부문 선정도서
이미 소장하고 있다면 판매해 보세요.
- 한정판매의 특성상 재고 상황에 따라 품절 가능
업체 공지사항
|
안내사항
안녕하세요, 저희 책방을 찾아주셔서 진심으로 감사드립니다.
저희는 부모님과 자녀가 함께 소중한 책들을 관리하고 운영하는 책방입니다. 직접 책방의 수많은 중고책을 직접 찾고, 검수하고, 안전하게 포장하여 배송해 드리고 있다 보니 조금의 시간이 걸릴 수 있는 점 너른 양해를 부탁드립니다.
방문해 주신 고객님들께 몇 가지 소중한 안내 말씀을 전합니다.
- 복수 구매 시 부분 취소 안내
중고책 특성상 실시간 재고 변동 등으로 인해, 2권 이상 주문해 주셨을 때 일부 도서의 품절 등으로 인해 부득이하게 부분 취소가 발생할 수 있습니다. 이 경우 미리 안내해 드린 후 신속하게 처리해 드리겠습니다.
- 문의 사항 안내 (문의글 이용 요청)
책을 찾고 포장하는 작업 중에는 전화 연결이 어렵습니다. 문의 사항이 있으실 경우 쇼핑몰 문의글(게시판)로 남겨주시면, 1일 이내(주말,공휴일 제외)에 친절하고 정확하게 답변해 드리겠습니다.
- 대량주문 (추가배송비)
10권 이상 주문해주시는 고객님들은 책에 따라 추가배송비가 발생될 수 있습니다. 추가 배송비가 나오는 경우는 미리 말씀드리겠습니다.
한 권의 책이 고객님께 무사히 닿을 수 있도록 정성을 다하겠습니다. 오늘도 좋은 하루 보내세요! 감사합니다 :)
|
|
안내사항
안녕하세요, 저희 책방을 찾아주셔서 진심으로 감사드립니다.
저희는 부모님과 자녀가 함께 소중한 책들을 관리하고 운영하는 책방입니다. 직접 책방의 수많은 중고책을 직접 찾고, 검수하고, 안전하게 포장하여 배송해 드리고 있다 보니 조금의 시간이 걸릴 수 있는 점 너른 양해를 부탁드립니다.
방문해 주신 고객님들께 몇 가지 소중한 안내 말씀을 전합니다.
- 복수 구매 시 부분 취소 안내
중고책 특성상 실시간 재고 변동 등으로 인해, 2권 이상 주문해 주셨을 때 일부 도서의 품절 등으로 인해 부득이하게 부분 취소가 발생할 수 있습니다. 이 경우 미리 안내해 드린 후 신속하게 처리해 드리겠습니다.
- 문의 사항 안내 (문의글 이용 요청)
책을 찾고 포장하는 작업 중에는 전화 연결이 어렵습니다. 문의 사항이 있으실 경우 쇼핑몰 문의글(게시판)로 남겨주시면, 1일 이내(주말,공휴일 제외)에 친절하고 정확하게 답변해 드리겠습니다.
- 대량주문 (추가배송비)
10권 이상 주문해주시는 고객님들은 책에 따라 추가배송비가 발생될 수 있습니다. 추가 배송비가 나오는 경우는 미리 말씀드리겠습니다.
한 권의 책이 고객님께 무사히 닿을 수 있도록 정성을 다하겠습니다. 오늘도 좋은 하루 보내세요! 감사합니다 :)
|
중고도서 소개
|
책소개
목차
|
제1장 그림으로 이해하는 강화학습
PART I 강화학습 구성 요소 PART II 환경(env) 예제 PART III 에이전트(agent) 예제 제2장 벨만 방정식(Bellman equation) PART I 보상과 평균 보상 PART II 할인율(discount rate) PART III 정책 π PART IV 정책 π로 행동할 때, 상태 s에서 평균 보상 PART V 정책 π로 행동할 때, 상태 가치(state value) PART VI 정책 π로 행동을 선택할 때, 상태-행동 가치 PART VII 벨만 기대 방정식(Bellman expectation equation) PART VIII 벨만 최적 방정식(Bellman optimality equation) 제3장 강화학습에 사용하는 기본 코드 PART I 환경 코드 PART II 정책 코드 PART III 환경-정책 상호작용 코드 제4장 동적 계획법(Dynamic programming) PART I 벨만 기대 방정식의 해를 코딩으로 구하기 PART II 최적의 정책을 코딩으로 구하기: 정책 반복(policy iteration) PART III 최적의 정책을 코딩으로 구하기: 가치 반복(value iteration) 제5장 몬테카를로(Monte Carlo, MC) PART I 에피소드(episode) PART II 처음 방문(first-visit) MC와 모든 방문(every-visit) MC PART III 중요도 표본추출 MC(importance sampling MC) 부록 125 제6장 SARSA와 Q-learning PART I SARSA 개요 PART II Q-learning 개요 PART III SARSA 업데이트 그림부터 코딩까지의 과정 PART IV Q-learning 업데이트 그림부터 코딩까지의 과정 제7장 깊은 Q-네트워크(Deep Q-Network, DQN) PART I 환경 CartPole-v0 소개 PART II 학습데이터, 신경망 구조와 손실함수 소개 PART III 그림으로 이해하는 DQN(Deep Q-Network, DQN) PART IV DQN 의사 코드 PART V DQN 코드 설명 PART VI DQN 전체 코드 제8장 Double DQN 제9장 Dueling DQN PART I Advantage A(s,a)의 평균을 빼는 이유 제10장 Max-PER(Prioritized Experience Replay) PART I 정책 신경망의 첫 번째 업데이트(Max-PER-DQN) PART II 정책 신경망의 두 번째 업데이트(Max-PER-DQN) PART III 정책 신경망의 세 번째 업데이트(Max-PER-DQN) PART IV Max-PER-DQN 전체 코드 PART V Max-PER-DoubleDQN 전체 코드 PART VI Max-PER-DuelingDQN 전체 코드 제11장 SumTree-PER(Prioritized Experience Replay) PART I 정책 신경망의 첫 번째 업데이트(SumTree-PER-DQN) PART II 정책 신경망의 두 번째 업데이트(SumTree-PER-DQN) PART III 정책 신경망의 세 번째 업데이트(SumTree-PER-DQN) PART IV SumTree-PER-DQN 전체 코드 PART V SumTree-PER-DoubleDQN 전체 코드 PART VI SumTree-PER-DuelingDQN 전체 코드 |
저자 소개 1
서울대학교에서 이학사, 이학석사, 이학박사를 취득한 후 울산대학교 수학과에 부임하였다. 현재까지 교수로 재임하면서 대규모 데이터에서 유용한 정보를 찾는 빅데이터 분석, 신경망의 기본인 순방향신경망, 언어 처리를 위한 순환신경망, 이미지 처리를 위한 합성곱신경망, 시행착오를 통해 최적의 행동을 학습하는 강화학습, attention을 이용하여 입력과 출력의 관계를 학습하는 트랜스포머, 전문가의 행동을 관찰하여 행동 전략을 학습하는 모방학습 등을 강의하고 있다. 집필한 저서는 다음과 같다.
신경망 학습이론과 PyTorch / 순환신경망과 PyTorch
합성곱신경망과 PyTorc
서울대학교에서 이학사, 이학석사, 이학박사를 취득한 후 울산대학교 수학과에 부임하였다. 현재까지 교수로 재임하면서 대규모 데이터에서 유용한 정보를 찾는 빅데이터 분석, 신경망의 기본인 순방향신경망, 언어 처리를 위한 순환신경망, 이미지 처리를 위한 합성곱신경망, 시행착오를 통해 최적의 행동을 학습하는 강화학습, attention을 이용하여 입력과 출력의 관계를 학습하는 트랜스포머, 전문가의 행동을 관찰하여 행동 전략을 학습하는 모방학습 등을 강의하고 있다. 집필한 저서는 다음과 같다.
신경망 학습이론과 PyTorch / 순환신경망과 PyTorch
합성곱신경망과 PyTorch / 강화학습 기본과 PyTorch*
강화학습 기본 다지기와 PyTorch / 강화학습 기본 완성과 PyTorch
*: 2024 세종도서 학술부문 선정도서
신경망 학습이론과 PyTorch / 순환신경망과 PyTorch
합성곱신경망과 PyTorch / 강화학습 기본과 PyTorch*
강화학습 기본 다지기와 PyTorch / 강화학습 기본 완성과 PyTorch
*: 2024 세종도서 학술부문 선정도서
품목정보
- 발행일
- 2023년 11월 30일
- 쪽수, 무게, 크기
- 264쪽 | 188*257*20mm
- ISBN13
- 9791158085599
상품정보안내
- 주문 전 중고상품의 정확한 상태 및 재고 문의는 [판매자에게 문의하기]를 통해 문의해 주세요.
- 주문완료 후 중고상품의 취소 및 반품은 판매자와 별도 협의 후 진행 가능합니다. 마이페이지 > 주문내역 > 주문상세 > 판매자 정보보기 > 연락처로 문의해 주세요.
부적합 상품 신고하기
신고하기- 구매에 부적합한 상품은 신고해주세요.
- 구매하신 상품의 상태, 배송, 취소 및 반품 문의는 판매자 묻고 답하기를 이용해주세요.
- 상품정보 부정확(카테고리 오등록/상품오등록/상품정보 오등록/기타 허위등록) 부적합 상품(청소년 유해물품/기타 법규위반 상품)
- 전자상거래에 어긋나는 판매사례: 직거래 유도
10,500원
총 1개
10,500원