
- 판매자
-
사업자
stayy5
중고샵 판매자가 직접 등록/판매하는 상품으로 판매자가 해당 상품과 내용에 모든 책임을 집니다.
이미 소장하고 있다면 판매해 보세요.
- 한정판매의 특성상 재고 상황에 따라 품절 가능
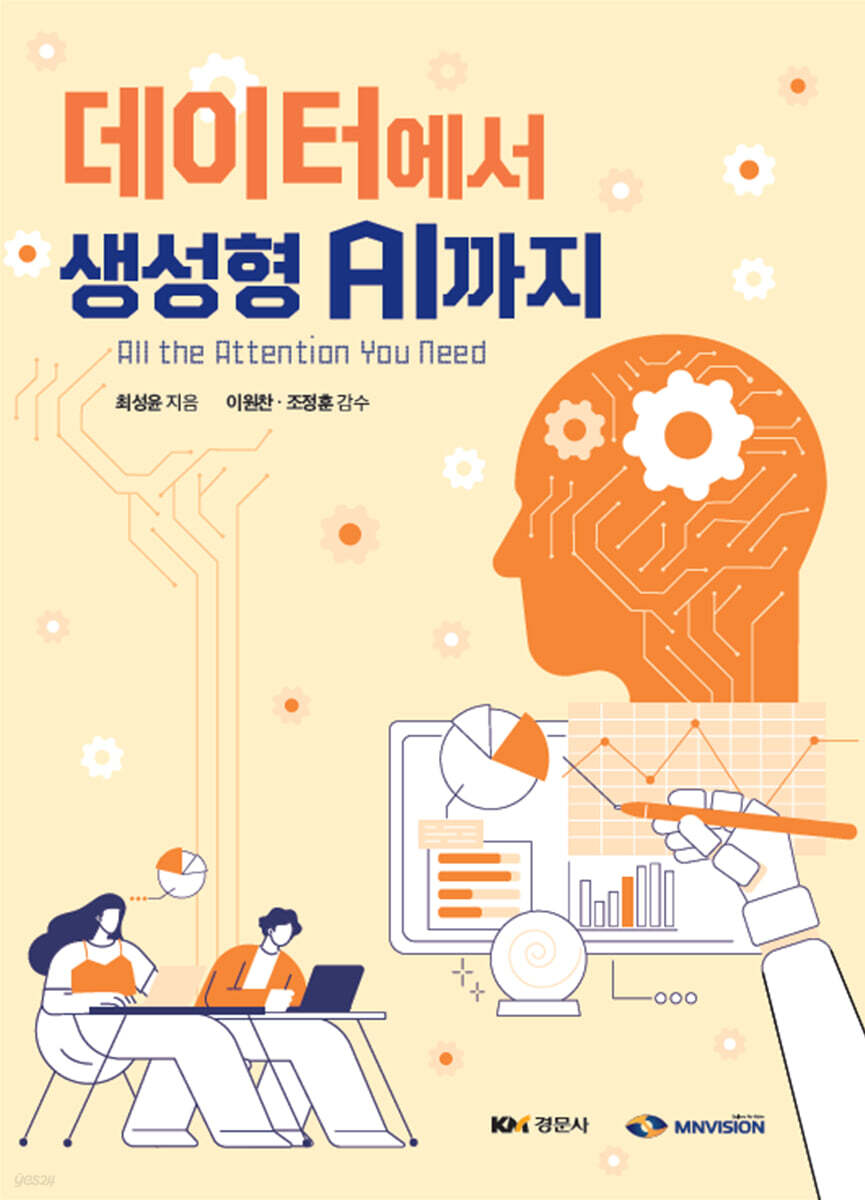
중고도서 소개
|
책소개
목차
|
Chapter 0
Before You Start 1. Linux 2. Python 버전 관리 3. Jupyter 4. CUDA/cuDNN 5. Windows Subsystem for Linux Chapter 1 Statistics for Data Analysis 1. Data Architecture 1.1. Introduction to AI world 1.2. RAM & VRAM***** 1.3. 데이터 컨테이너 1.4. DataType 1.5. NaN 1.6. ndarray 1.7. Broadcasting 1.8. 벡터화 1.9. View & Copy 2. 데이터 종류 및 분류 2.1. 측정 척도 2.2. 회색지대/함정(오개념 방지에 대한 설명) 2.3. 결정 예시 2.4. 데이터 포맷 2.5. Python에서 데이터를 읽기 3. 추론 통계 3.1. 목적과 용어 3.2. 가설검정 3.3. 효과 크기와 실무적 중요성 4. 상관분석 / 회귀분석 4.1. 상관분석 4.2. 회귀 4.3. 진단 후 강건화 4.4. 정규화 회귀 4.5. 회귀의 목적: 예측과 설명 5. Question Chapter 2 Big Data and Machine Learning 0. Introduction to Machine Learning 1. 기계학습 개념 및 프로세스 이해 1.1. 문제정의와 목표함수 1.2. 데이터 수명주기와 파이프라인 1.3. 데이터 분할 전략 2. 학습별 모델 성능평가 지표 및 튜닝 방법 이해 2.1. 분류(Classification) 2.2. 분류 실습 과제: MNIST 손글씨 숫자 인식 2.3. 회귀(Regression) 2.4. 회귀 연습: UCI Bike Sharing 2.5. Anomaly Detection 2.6. 과제: 이상치 감지 사례 3. 지도학습 분류/회귀 모델 활용 3.1. k-Nearest Neighbors Classifier 3.2. Linear Regression 3.3. Logistic Regression 3.4. Decision Tree 3.5. Random Forest 3.6. Support Vector Machine 3.7. Gradient Boosting 3.8. Naive Bayes 3.9. Questions 4. 비지도학습 모델 이해 및 활용 4.1. K-means 4.2. Hierarchical Clustering 4.3. Density-based spatial clustering of applications with noise 4.4. Principal Component Analysis 4.5. t-distributed stochastic neighbor embedding 4.6. Isolation Forest 4.7. Local Outlier Factor 4.8. Questions Chapter 3 Computer Vision Programming 1. Computer Vision Concept & Image Architecture 1.1. Pixel and Video 1.2. 색과 밝기 1.3. Image File Format 1.4. 메타데이터 1.5. 카메라 이미지 파이프라인 1.6. 표본화와 보간 1.7. 카메라와 기하 1.8. Computational Thinking+ 1.9. 주파수 2. 이미지 데이터 기본 처리 2.1. 입출력과 시각화 2.2. Region of Interest & Masking 2.3. 기울기, 엣지, 코너 2.4. 밝기 히스토그램 2.5. 노이즈와 평활화 2.6. 이진화 2.7. 모폴로지 2.8. 주파수 필터링 부록 OpenCV 함수 정리 3. Questions Chapter 4 Basic Deep Learning 0. Intro 0.1. Introduction to Deep Learning 0.2. 가속 하드웨어와 딥러닝+ 1. 텐서와 자동미분 1.1. Shape 1.2. dtype 1.3. 브로드캐스팅 1.4. View & Copy 1.5. 벡터화(Vectorization) 1.6. 그래디언트 2. 손실함수와 확률적 출력 2.1. Logit 2.2. Sigmoid & Softmax 2.3. CrossEntropy 2.4. Threshold 3. 다층 퍼셉트론(MLP) 3.1. Single Layer Perceptron 3.2. MLP 3.3. MLP on UCI Wine with Torch 3.4. MLP on UCI Wine with TensorFlow/Keras 3.5. Activation Function 3.6. Dropout 3.7. Backpropagation 4. Convolutional Neural Network 4.1. Convolution 4.2. Kernel 4.3. Stride 4.4. Padding 4.5. Pointwise Convolution 4.6. Normalization 4.7. Computational Cost 4.8. Pooling 4.9. 수용 영역 5. CNN Models 5.1. AlexNet(2012) 5.2. Inception(2014) 5.3. VGG-16(2014) 5.4. ResNet 5.5. MobileNet 5.6. UNet 6. 전이학습 이해 및 활용 6.1. Transfer Learning 6.2. 학습 안정화 7. Questions 7.1. Part 1 7.2. Part 2 Chapter 5 Transfer Learning-based Models 1. Object Detection 1.1. 문제 정의 1.2. 평가 지표 1.3. Two-stage 1.4. One-Stage-You Only Look Once 1.5. Anchor vs Anchor-free 1.6. 학습 요소 1.7. 성능 저하의 원인들 1.8. Pretrained backbone 2. You Only Look Once 2.1. YOLO의 구조 2.2. 입력과 출력 파이프라인 2.3. YOLO 학습 감각 2.4. YOLO 추론과 배포 2.5. 사전학습 YOLO를 나만의 데이터에 전이 학습하기 3. GAN 개념 및 구조 이해와 활용 3.1. Generative Adversarial Network 3.2. 기본에서 변종 GAN으로 3.3. GAN 학습 감각 4. HuggingFace 4.1. HuggingFace 기반 전이학습 4.2. HuggingFace에서 자주 쓰는 모델들 4.3. State of the Art 5. Questions Chapter 6 NLP 1. Introduction to Natural Language Processing 1.1 Definition of NLP 1.2. 이해 생성 변환 1.3. 처리 단위 1.4. 규칙 기반의 전통적 자연어 처리 1.5. 신경망 기반 NLP 2. 데이터 전처리 과정 및 방법 2.1. 텍스트 정규화 2.2. English vs Korean 2.3. Tokenization 2.4. 정제 2.5. 라벨 품질 관리 3. RNN / LSTM 구조 이해 및 활용 3.1. 순환신경망 기본 3.2. Long Short-Term Memory 3.3. Gated Recurrent Unit 3.4. Seq2Seq 4. Transformer 4.1. Attention is All You Need 4.2. 표준 트랜스포머 아키텍처 4.3. Transformer 계열과 학습 목표 4.4. 미세 조정 4.5. Optimization 4.6. Retrieval-Augmented Generation 5. Last Page |
저자 소개 3
Lucius Choi
미국 캘리포니아대학교 어바인(UC Irvine) 공과대학
전기·컴퓨터공학과 석사(M.Eng.)
컴퓨터공학과 학사(B.S.)
이메일: seongyuc@uci.edu
Wonchan Lee
고려대학교 전자공학과 Ph.D. (영상정보처리 및 인공지능)
서울대학교 인공지능대학원 교수
사단법인 한국인공지능기술산업협회 협회장
이메일: king@kaitia.com
품목정보
- 발행일
- 2026년 01월 30일
- 쪽수, 무게, 크기
- 492쪽 | 188*257*30mm
- ISBN13
- 9791160738193
출판사 리뷰
|
감수자 추천사(이원찬):
요즘 데이터 사이언스와 인공지능은 연구실을 넘어 산업과 교육 현장 전반으로 빠르게 확산되고 있으며, 이제는 특정 전공자만의 영역이 아니라 누구나 이해해야 할 기본 소양으로 자리 잡아가고 있습니다. 하지만 막상 이 분야를 처음 접하는 독자들에게는 개념도, 활용 방식도 다소 막연하게 느껴지는 것이 사실입니다. 이 책은 이러한 어려움에서 출발하여, 데이터 사이언스의 기초적인 실무와 실습을 차분하고 성실하게 담아낸 입문서입니다. 복잡하게 느껴질 수 있는 인공지능과 데이터 분석의 기본 개념을 실제 활용의 맥락 속에서 풀어내어, 독자가 자연스럽게 이해할 수 있도록 돕는 점이 인상적입니다. 단순히 따라 해보는 실습에 그치지 않고, ‘왜 이렇게 되는지’를 함께 생각해 볼 수 있도록 구성되어 있어 학습의 깊이를 더해 줍니다. 또한 본서는 개념 설명과 실습을 균형 있게 배치하여, 자기주도 학습을 원하는 독자는 물론 교육 현장에서도 충분히 활용할 수 있는 구조를 갖추고 있습니다. 데이터 사이언스와 인공지능을 처음 배우는 학습자들이 부담 없이 접근하면서도, 핵심을 놓치지 않고 학습할 수 있도록 세심하게 설계된 점이 돋보입니다. 앞으로 인공지능 디지털 교과서(AIDT)가 본격적으로 자리 잡아가는 흐름 속에서, 학습 목표와 학습 방향에 대한 안내가 조금 더 보완된다면 이 책의 교육적 가치는 더욱 커질 것으로 기대됩니다. 그러한 보완을 통해 본서는 데이터 사이언스와 인공지능을 처음 배우는 독자들이 믿고 따라갈 수 있는 든든한 길잡이가 될 것입니다. 이 책을 통해 더 많은 독자들이 데이터 사이언스와 인공지능의 세계에 한 걸음 더 가깝게 다가가기를 기대하며, 이 분야에 첫발을 내딛고자 하는 분들께 이 책을 기꺼이 추천합니다. 감수자 추천사(조정훈): 요즘 인공지능은 우리 생활 곳곳에서 활용되고 있으며, 앞으로 그 쓰임새는 더욱 넓어질 것으로 보입니다. 예전에 C 언어가 프로그래밍의 기초였다면, 이제는 인공지능에 대한 이해가 새로운 기본 소양이 되어 가고 있다고 해도 과언이 아닙니다. 하지만 인공지능을 공부하다 보면 생각보다 어렵고 막연하게 느껴질 때가 많습니다. 그 이유 중 하나는 많은 교재들이 수학적 원리에 대한 설명은 부족한 채, 프로그래밍 방법 위주로만 다루고 있기 때문입니다. 그러다 보니 “왜 이렇게 되는지”를 이해하지 못한 채 따라가기만 하게 되는 경우가 적지 않습니다. 이 교재는 이런 고민에서 출발해, 수학에 대한 부담이 크지 않은 독자라도 인공지능의 핵심 개념을 차근차근 이해할 수 있도록 구성되어 있습니다. 복잡해 보이는 인공지능의 원리를 수학적 기반 위에서 쉽게 풀어 설명하고, 실습을 통해 직접 확인해 볼 수 있도록 도와줍니다. 인공지능을 처음 접하는 학생은 물론, 개념을 제대로 이해하고 싶은 일반 독자에게도 이 교재는 매우 좋은 안내서가 될 것입니다. 인공지능을 어렵지 않게, 그러나 깊이 있게 배우고 싶은 분들께 이 책을 적극 추천합니다. |
상품정보안내
- 주문 전 중고상품의 정확한 상태 및 재고 문의는 [판매자에게 문의하기]를 통해 문의해 주세요.
- 주문완료 후 중고상품의 취소 및 반품은 판매자와 별도 협의 후 진행 가능합니다. 마이페이지 > 주문내역 > 주문상세 > 판매자 정보보기 > 연락처로 문의해 주세요.
판매자 정보
- 업체명
- 오제웅
- 대표자명
- 오제웅
- 사업자 등록번호
- 398-51-00030
- 사업자 종목
- 서점
- 고객 상담 전화번호(유선)
- 062-375-5084
- 고객 상담 이메일
- stayy5@gmail.com
- 배송 방법
- 타사택배(CJ대한통운)
- 본사 소재지
- 광주광역시 서구 풍암동 802-1 CU 뒤편 스테이 책터
- 발송지 주소
- 광주광역시 서구 내방동 842-12 금성빌딩 201호
- 반품지 주소
- 광주광역시 서구 내방동 842-12 금성빌딩 201호
부적합 상품 신고하기
신고하기- 구매에 부적합한 상품은 신고해주세요.
- 구매하신 상품의 상태, 배송, 취소 및 반품 문의는 판매자 묻고 답하기를 이용해주세요.
- 상품정보 부정확(카테고리 오등록/상품오등록/상품정보 오등록/기타 허위등록) 부적합 상품(청소년 유해물품/기타 법규위반 상품)
- 전자상거래에 어긋나는 판매사례: 직거래 유도
49,000원
총 1개
49,000원
