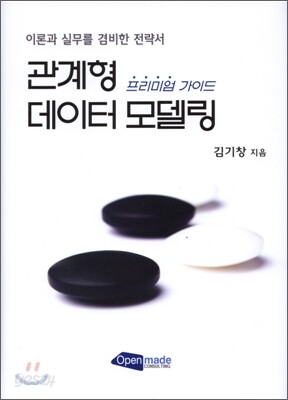
- 본 도서의 개정판이 출간되었습니다.
이미 소장하고 있다면 판매해 보세요.
- 해외배송 가능?
- 문화비소득공제 가능
책소개
목차
|
Prologue
01 데이터 모델링에 대한 상념(想念) 1.1. 데이터 모델링이 왜 어려운가? 1.2. 데이터 모델링의 매력 1.3. 모델링은 상식적이다 1.4. 모델러와 바둑 프로기사 1.5. 좋은 모델은? 1.6. 모델링이 왜 필요한가? 1.7. 좋은 모델러란? 1.8. 모델링 목표 02 데이터 모델링 기본 개념 2.1. 관계형 데이터 모델링(Relational Data Modeling) 2.2. 무결성(Integrity) 2.3. 데이터베이스 라이프 사이클 2.4. 주제 영역(Subject Area) 2.5. 데이터 표준화 2.6. ERD(Entity Relationship Diagram) 03 개념 모델 & 논리 모델 & 물리 모델 3.1. 개념 모델(Conceptual Model) 3.2. 논리 모델(Logical Model) 3.3. 물리 모델(Physical Model) 04 정규화(Normalization) 4.1. 정규화(Normalization)란? 4.2. 정규화의 목적 4.3. 아노말리(Anomaly) 4.4. 함수 종속(Functional Dependency) 4.5. 정규형의 종류 1정규형 2정규형 3정규형 보이스코드 정규형 4정규형 5정규형 4.6. 정규형과 성능 05 데이터 통합(Generalization) 5.1. 데이터 통합(Generalization) 5.2. 데이터 통합의 장?단점 데이터 통합의 장점 데이터 통합의 단점 5.3. 엔터티 통합 대상 5.4. 데이터 오너십 06 슈퍼타입(Supertypes)과 서브타입(Subtypes) 6.1. 슈퍼타입 & 서브타입 정의 6.2 슈퍼타입과 서브타입의 사용 방법 6.3. 서브타입의 종류 6.4. 서브타입의 물리모델 변환 서브타입별 엔터티로 분할(타입1) 하나의 엔터티로 통합(타입2) 하나의 엔터티로 통합(타입3) 07 엔터티(Entity) 7.1. 엔터티란? 7.2. 자립(Independent) 엔터티 & 종속(Dependent) 엔터티 7.3. 엔터티 종류 실체 엔터티 행위 엔터티 가공 엔터티 기준 엔터티 7.4. 엔터티 도출 원칙 7.5. 엔터티명 7.6. 엔터티 검증 08 식별자(Unique Identifier) 8.1. 업무 식별자(Business Identifiers)란? 8.2. 식별자(UID)/키(PK) 종류 8.3. 주 식별자 선정 원칙 8.4. 주 식별자 선정 절차 8.5. 주 식별자 상속 8.6. PK 제약과 유니크 인덱스 8.7. 인조 식별자 채번 8.8. 복잡한 주 식별자 8.9. 식별자 검증 09 속성(Attributes) 9.1. 속성이란? 9.2. 속성 종류 기초 속성(Basic Attributes) 관계 속성(Relationship Attributes) 추출 속성(Derived Attributes) 시스템 속성(System Attributes) 9.3. 도메인(Domain) 9.4. 복합 속성 & 다가 속성 9.5. 속성명 9.6. 코드에 관해서 속성 코드와 식별자 코드 코드 모델 9.7. 널(Null)에 관해서 9.8. 데이터 타입 9.9. 속성 검증 10 관계(Relationships) 10.1. 관계(Relationships)란? 10.2. 관계와 속성 그리고 엔터티 10.3. 관계 구성 요소 카디널러티(Cardinality) 옵셔널러티(Optionality 관계 디그리(Relationship Degree) 10.4. 관계 표현 10.5. 관계 종류 일대일(1:1) 관계 배타 관계 순환 관계 추출 관계 양 방향 관계 10.6. 참조 무결성(Referential Integrity) 10.7. 관계 검증 11 모델링 방법론(Modeling Methodology) 11.1. 하향식(Top-Down)과 상향식(Bottom-Up) 11.2. 리버스(Reverse) 모델링 11.3. 모델링 프로젝트 WBS(Work Breakdown Structure) 12 이력관리 12.1. 이력 데이터란? 12.2. 선분 이력 12.3. 이력 엔터티 선정 절차 12.4. 이력 관리 모델 유형 12.5. 이력 엔터티의 주 식별자 12.6. 정정 데이터 13 비정규화(Denormalization) 13.1. 비정규화란? 13.2. 비정규화 과정 13.3. 비정규형의 단점 13.4. 비정규화 방법 엔터티 합체 엔터티 분해 요약(Summary) 엔터티 추가 중복 속성 채택 추출 속성 채택 반복 속성 채택 중복 데이터 채택 14 물리적(DBMS) 요소 14.1. 테이블 타입 클러스터링 테이블(Clustering Table) IOT(Index Organized Table) 14.2. 파티션 14.3. 인덱스 14.4. 뷰 Bibliography Index |
저자 소개
저자 : 김기창
데이터 분야에서 10년째 일하고 있으며 현재는 오픈메이드컨설팅에서 수석 컨설턴트로 근무하고 있다. DA(Data Architecture) 컨설팅과 DB 튜닝, 데이터 모델링을 주로 수행하며 진정한 데이터 프로페셔널(Data Professional)이 되려고 노력하고 있다.‘전사적 데이터 아키텍처 프레임웍에 대한 개념모델 개발’ 논문을 발표했고, 저서로는 ‘데이터베이스 활용을 위한 SQL Server 2000’이 있다.
E-mail: bluepupi@gmail.com
Blog: http://blog.naver.com/bluepupils
E-mail: bluepupi@gmail.com
Blog: http://blog.naver.com/bluepupils