이미 소장하고 있다면 판매해 보세요.
- 해외배송 가능?
- 문화비소득공제 가능
베스트 프랙티스 시리즈
이 상품의 시리즈 알림신청
이 상품의 태그
책소개
목차
|
1부 예제로 배우는 PL/SQL
1장 PL/SQL이란? PL/SQL이란? PL/SQL의 필요성 PL/SQL의 장점 PL/SQL 아키텍처(Architecture) 2장 테스트 환경 구성(1부) 3장 PL/SQL 블록 구조 익명 블록 주석 4장 DBMS_OUTPUT 패키지 5장 식별자와 변수 PL/SQL 문자 집합 식별자 규칙 변수 선언 변수 범위와 가시성 문자열 안에 작은 따옴표 사용하기 6장 데이터 타입 스칼라 타입 조합 타입 LOB 타입 % 타입 사용자 정의 서브타입 데이터 타입 간 형 변환 7장 테이터 조작 DML 조작 커밋 롤백 세이브포인트 ROLLBACK TO SAVEPOINT SET TRANSACTION 8장 NULL 제어 9장 프로시저 프로시저 생성 입/출력 매개변수 프로시저 실행 방법 프로시저 제거 프로시저 Invalid 시 재컴파일(Re-Compile) 방법 10장 함수 함수 생성 Deterministic 함수 생성 함수 실행 함수 제거 프로시저와 함수의 차이 11장 패키지 패키지 생성 전역 변수 선언 시 유의사항 프로시저 및 패키지 변경 시 주의 사항 패키지 컴파일 12장 IN OUT 모드-NOCOPY: call by reference NOCOPY란 NOCOPY 유의점 13장 권한 관리 권한 관리 권한 취소 권한 부여 시 주의사항 조회 스키마 관리 14장 제어 구문 IF 문 CASE 문 GOTO 및 레이블 Loop 중첩 Loop While Loop For Loop 커서(Cursor) For Loop 15장 내장 함수 타입 변환 함수 숫자 표기 형식 날짜 표기 형식 문자열 관련 함수 수치 함수 날짜 함수 16장 커서 관리 명시적 커서와 암시적 커서 암시적 커서 명시적 커서 For Loop와 커서를 활용한 Update 문 튜닝 17장 자율 트랜잭션 자율 트랜잭션의 특징 자율 트랜잭션 생성 자율 트랜잭션 활용 방안 자율 트랜잭션으로 인한 데드락 자율 트랜잭션 선언 위치 18장 예외 처리 예외 처리 개요 컴파일 경고(Compile-Time Warnings) 예외 처리 문법 예외 처리 종류 선행 정의 예외 내부 정의 예외-EXCEPTION_INIT Pragma 사용자 정의 예외(User-Defined Exceptions)-RAISE 사용자 정의 예외(User-Defined Exceptions)-RAISE_APPLICATION_ERROR 에러 발생한 부분 건너뛰어 계속 실행하기(9i 이하) DML 에러 로깅 기능 활용 (10g R2 이상) 19장 REF 커서 REF 커서 타입 REF 커서 사용 예 REF 커서 제약 바인드 변수를 활용한 REF 커서 사용 REF 커서의 장점 20장 컬렉션 Nested Table 컬렉션 Varray 컬렉션 Index-by Table 컬렉션 컬렉션 함수 컬렉션 타입 정의 및 초기화 컬렉션 확장(EXTEND) 컬렉션 삭제 및 제거 컬렉션 예외 처리 Nested Table 컬렉션 사용 예 Varray 컬렉션 사용 예 Index by Table 컬렉션 사용 예 21장 Bulk 처리와 ForAll Bulk Collect Fetch 사이즈에 따른 PGA 변화량 ForAll이란? ForAll을 이용한 Delete ForAll을 이용한 Update ForAll을 이용한 Insert BULK COLLECT~LIMIT과 ForAll For와 ForAll의 성능 차이 ForAll을 이용한 Merge ForAll 예외 처리 - SAVE EXCEPTIONS Returning 절 ForAll과 INDICES OF 절 ForAll과 VALUES OF 22장 Table 함수 Table 함수 Pipelined Table 함수 SQL 커서를 이용한 Table 함수 컬렉션을 이용한 Table 함수 Table 함수와 조인 멀티 칼럼을 반환하는 스칼라 서브쿼리 23장 호출자 권한 DML 비교 DDL 비교 24장 동적 SQL NDS를 이용한 동적 SQL DBMS_SQL을 이용한 동적 SQL 동적SQL을 위한 오라클 11g의 새로운 기능들 25장 성능 진단 패키지(DBMS_PROFILER) DBMS_PROFILER 패키지 DBMS_TRACE 패키지 DBMS_HPROF 패키지 26장 세션 모니터링을 위한 DBMS_APPLICATION_INFO 패키지 DBMS_APPLICATION_INFO 패키지 함수 JDBC 내 DBMS_APPLICATION_INFO 패키지 사용 27장 트리거 트리거 생성 트리거 종류 DDL 트리거 Instead-Of 트리거 28장 병렬 처리 함수 병렬 처리 DBMS_JOB을 이용한 매뉴얼한 병렬 처리 DBMS_PARALLEL_EXECUTE 패키지 29장 새로운 기능들(11g New Features) CONTINUE 문 Result Cache 네이티브 컴파일러 PL/SQL 안의 시퀀스 사용 2부 성능 개선과 운영 안정성 사례로 배우는 PL/SQL 30장 테스트 환경 구성(2부) 샘플 스키마 생성 테스트 테이블 생성 성능 분석을 위한 패키지 생성 성능 관련 중요한 세 가지 지표 31장 SQL VS PL/SQL(1)-PL/SQL 안에서의 SQL 성능 32장 SQL VS PL/SQL(2)-SQL 안에서의 SQL 성능 33장 함수를 최소한으로 호출하라 34장 OPEN CURSOR 대신 FOR LOOP를 사용하라 35장 LOOP 안의 SQL은 한번 더 생각하라(1) 36장 LOOP 안의 SQL은 한번 더 생각하라(2) 37장 불필요한 시퀀스 사용을 제거하라 38장 건바이건 Commit을 최소화하라 39장 Insert & Update를 Merge로 변경하라 40장 EXCEPTION 처리 시 WHEN OTHERS 사용에 주의하라 41장 반복 Insert를 BULK Insert로 변경하라(1) 42장 반복 Insert를 BULK Insert로 변경하라(2) 43장 반복 Delete를 BULK Delete로 변경하라 44장 반복 Insert 시 APPEND_VALUES를 고려하라 45장 하드 파싱(Hard Parsing)을 피하라(1) 46장 하드 파싱(Hard Parsing)을 피하라(2) 47장 동시성을 고려하라(1) 48장 동시성을 고려하라(2) 49장 동시성을 고려하라(3) 50장 자율 트랜잭션에 대해 이해하라(1) 51장 자율 트랜잭션에 대해 이해하라(2) 52장 Table 함수의 조인 순서를 주의하라 53장 멀티 칼럼, 멀티 행을 반환하는 스칼라 서브쿼리 54장 COUNT(*) 사용에 주의하라 55장 트리거 사용 시 에러를 피하라 56장 Client-Side 프로그래밍 대신 패키지를 사용하라(1) 57장 Client-Side 프로그래밍 대신 패키지를 사용하라(2) 58장 프로시저 대신 패키지를 사용하라 59장 패키지에 전역(GLOBAL) 변수 사용을 최소화하라 60장 DBMS_AQ(ADVANCED QUEUE)를 이용하면 데이터 전송이 편리해진다 61장 Database Link 호출을 최소화하라 부록 부록 A 자바 JDK 설치 가. 윈도우즈 설치 나. Linux 설치 부록 B 오라클 제공 패키지 DBMS_UTILITY DBMS_LOCK DBMS_PIPE DBMS_RANDOM DBMS_LOB UTL_RAW UTL_METADATA UTL_FILE DBMS_CRYPTO DBMS_JOB DBMS_XPLAN 찾아보기 |
저자 소개
저 자 소 개
장정수
컴퓨터공학을 전공하였으며, 2001년 SK C&C에 입사하여 셀파소프트를 거쳐 현재 엑시엄에서 활동 중입니다. 메인프레임 시스템 엔지니어로부터 시작하였으나 DBA로 전향하여 SK 텔레콤의 주요 데이터베이스 운영 및 성능 개선 업무를 수행하였으며, 이 후 LG이노텍, SK하이닉스, AK몰, 철도공사 등 다양한 고객사에서 DB 성능 개선 및 SQL, PL/SQL 튜닝 컨설팅을 담당하였습니다. 오라클 10g OCP 및 SQLP, DAP, 리눅스 마스터 등 다양한 자격증도 보유하고 있습니다.
송현호
SK C&C의 인프라 조직에서 회사 생활을 시작해 지금까지 8년째 DBA 업무를 수행하고 있습니다. SK 그룹 사내 및 외부에서 다양한 분야의 데이터베이스에 대한 운영, 구축, 튜닝 업무를 수행했으며, 현재는 SKT 주 과금 시스템 및 관련 시스템의 운영 리더를 맡고 있습니다. 월간 마이크로소프트웨어에 기고한 이력이 있으며, 번역서로는 가장 쉬운 데이터베이스 설계(2014)가 있습니다.
컴퓨터공학을 전공하였으며, 2001년 SK C&C에 입사하여 셀파소프트를 거쳐 현재 엑시엄에서 활동 중입니다. 메인프레임 시스템 엔지니어로부터 시작하였으나 DBA로 전향하여 SK 텔레콤의 주요 데이터베이스 운영 및 성능 개선 업무를 수행하였으며, 이 후 LG이노텍, SK하이닉스, AK몰, 철도공사 등 다양한 고객사에서 DB 성능 개선 및 SQL, PL/SQL 튜닝 컨설팅을 담당하였습니다. 오라클 10g OCP 및 SQLP, DAP, 리눅스 마스터 등 다양한 자격증도 보유하고 있습니다.
송현호
SK C&C의 인프라 조직에서 회사 생활을 시작해 지금까지 8년째 DBA 업무를 수행하고 있습니다. SK 그룹 사내 및 외부에서 다양한 분야의 데이터베이스에 대한 운영, 구축, 튜닝 업무를 수행했으며, 현재는 SKT 주 과금 시스템 및 관련 시스템의 운영 리더를 맡고 있습니다. 월간 마이크로소프트웨어에 기고한 이력이 있으며, 번역서로는 가장 쉬운 데이터베이스 설계(2014)가 있습니다.
품목정보
- 발행일
- 2015년 04월 28일
- 쪽수, 무게, 크기
- 678쪽 | 1265g | 190*240*32mm
- ISBN13
- 9788994797205
책 속으로
|
암묵적으로 형 변환이 일어날 경우 운영 중에 프로그램의 성능 저하 또는 에러가 발생할 수 있으므로 각 변수의 형 변환이 필요할 경우에는 반드시 명시적으로 기술되도록 노력해야 합니다. 또한 변수 선언 시 데이터 타입이 서로 간에 정확히 일치하도록 선언해야 합니다. (p. 60)
커밋(Commit)이 되지 않으면 락이 해제되지 않기 때문에 커밋을 자주 해야 성능상 유리하다고 믿고 있는 개발자분들이 많이 있습니다. … 중략 … 매번 커밋을 하면 오히려 성능과 운영 안정성에 문제가 발생할 수 있습니다. (p. 62) 오라클 데이터베이스 버전이 10g 이상이라면, 데이터를 추출하기 위한 Fetch Call을 최소화하기 위해 Open-Fetch-Close 절 보다는 For Loop를 사용하는 것이 성능에 유리합니다. (p. 145) For Loop를 이용하는 것보다 4배나 빠른 성능을 보여주고 있습니다. 따라서 대량의 데이터 처리를 위해서는 ForAll을 사용하는 것이 권장됩니다. (p. 242) 조인 조건인 empno의 값이 인라인뷰 안으로 파고들지 못해 인라인뷰를 전체 처리해야 하는 비효율이 종종 발생합니다. 이러한 경우에 Group by가 사용된 인라인뷰를 스칼라 서브쿼리로 변환하여, 조인 조건이 뷰 안으로 파고들도록 하여 필요한 건수에 대해서만 Group by가 수행되도록 할 수 있습니다. (p. 270) 많은 경우 병렬 처리를 위해 SQL 안에 PARALLEL 힌트를 사용하여 처리하는데, 이때 SQL 안에 PL/SQL로 작성된 함수가 있다면 주의를 해야 합니다. 왜냐하면 함수를 어떻게 생성했느냐에 따라서 병렬 처리가 될 수도 있고 그렇지 않을 수도 있기 때문입니다. (p. 337) 다른 건 변경하지 않고 For Loop 안의 SELECT 문장만 커서 안에 포함시켰을 뿐인데 실행 시간이 39.6초에서 1.59초로 단축되었습니다. (p. 392) Fetch Call 횟수를 줄이는 방법은 각 프로그래밍 언어마다 제공되고 있기 때문에 특히 많은 건수의 데이터를 조회하는 화면에서는 반드시 Fetch하는 단위 사이즈를 증가시켜야 합니다. (p. 398) 이처럼 함수 하나를 제거하였을 뿐인데 많은 성능 차이가 발생한 것을 확인할 수 있습니다. 이와 같이 SQL의 내장 함수를 이용하여 구현할 수 있는 것들도 습관적으로 함수를 이용하여 결과를 확인하는 SQL이 다수 존재합니다. (p. 402) 트랜잭션의 제일 중요한 요소(element)는 정합성입니다. 모두 반영이 되거나, 그렇지 않거나 둘 중 하나가 되어야지, 하나는 반영이 됐는데 다른 하나는 반영이 되지 않으면 나중에 데이터 정합성에 문제가 발생할 수 있으므로 성능을 떠나 가능한 커밋은 프로그램 맨 마지막에 한번만 수행이 되도록 작성하는 것이 좋습니다. (p. 447) 금융권에서 Lost Update가 발생하면 고객의 돈이 사라지거나, 중복되어 추가 지출될 수 있기 때문에 주의를 기울여야 하는 부분입니다. (p. 531) 하나의 인터페이스 프로그램이 아닌 수십 개의 프로그램에서 매 초마다 작업 대상이 있는지 여부를 확인하기 위해 폴링할 경우 시스템에 과부하를 발생시킬 수 있는데, 이런 경우에도 AQ는 매우 효과적인 대안이 될 수 있습니다. (p. 644) ___본문 중에서 |
출판사 리뷰
|
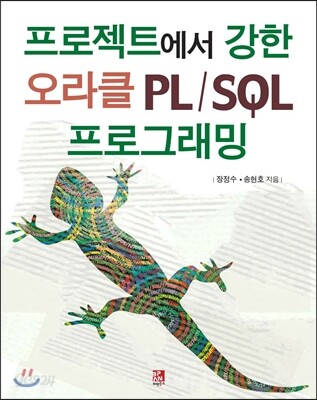
오라클 DBMS와의 연동에 최적화된 PL/SQL 전문서
최근 들어 새로운 데이터베이스의 등장과 견제로 어느 때보다 오라클의 위상이 위협을 받고 있습니다. 요즘 IT의 트렌드인 빅데이터 관련한 Hadoop, NoSQL 뿐 아니라 국산 DBMS인 티베로, 알티베이스, 큐브리드와 더불어 SAP의 HANA DBMS까지 새로운 기술과 데이터베이스가 오라클이 잠식하고 있던 자리를 꿰차고 있습니다. 그러나 성능과 안정성이 요구되는 주요 업무에서는 여전히 오라클을 대체하기엔 역부족인 것 같습니다. 향후 10년 후에는 어떤 변화가 있을지 예측하기 어렵지만 현재로서는 오라클의 RAC라는 강력한 기능으로 인해 당분간 확고한 지위를 유지하리라 생각됩니다. 이러한 오라클 DBMS와 연동하여 데이터를 처리하기 위해 PL/SQL만큼 빠르고 데이터 조작이 쉬운 언어는 없어 보입니다. 1부에서는 핵심 예제, 2부에서는 실제 적용 사례 1부, “예제로 배우는 PL/SQL”에서는 간단한 예제를 중심으로 PL/SQL의 기본 기능을 살펴봅니다. 기존에 출간되었던 PL/SQL 전문서들은 너무 많은 장 수에 걸쳐 기능 설명을 해두어서 책을 펼쳐 볼 엄두가 나지 않았을 수 있습니다. 그러나 이 책은 짧은 시간 안에 예제 실습을 통해 주요 핵심 내용을 배울 수 있도록 했습니다. 2부, “성능 개선과 운영 안정성 사례로 배우는 PL/SQL”에서는 성능 개선을 위해 필요한 부분은 무엇인지, 어떻게 해야 프로그램을 안정적으로 작성할 수 있는지에 관련된 사례들을 하나씩 실습합니다. 이를 통해 얼마 안 되는 코딩으로 성능이 얼마나 빨라질 수 있는지, 이전에 간과하여 장애나 데이터 정합성 유지에 어려움을 겪었던 원인이 무엇이었는지를 알 수 있습니다. |
사락 별점0
혜택 및 유의사항밑줄0
혜택 및 유의사항
36,000원
총 1개
36,000원