소득공제
- 베스트
- IT 모바일 top20 4주
이미 소장하고 있다면 판매해 보세요.
- 해외배송 가능?
- 문화비소득공제 가능
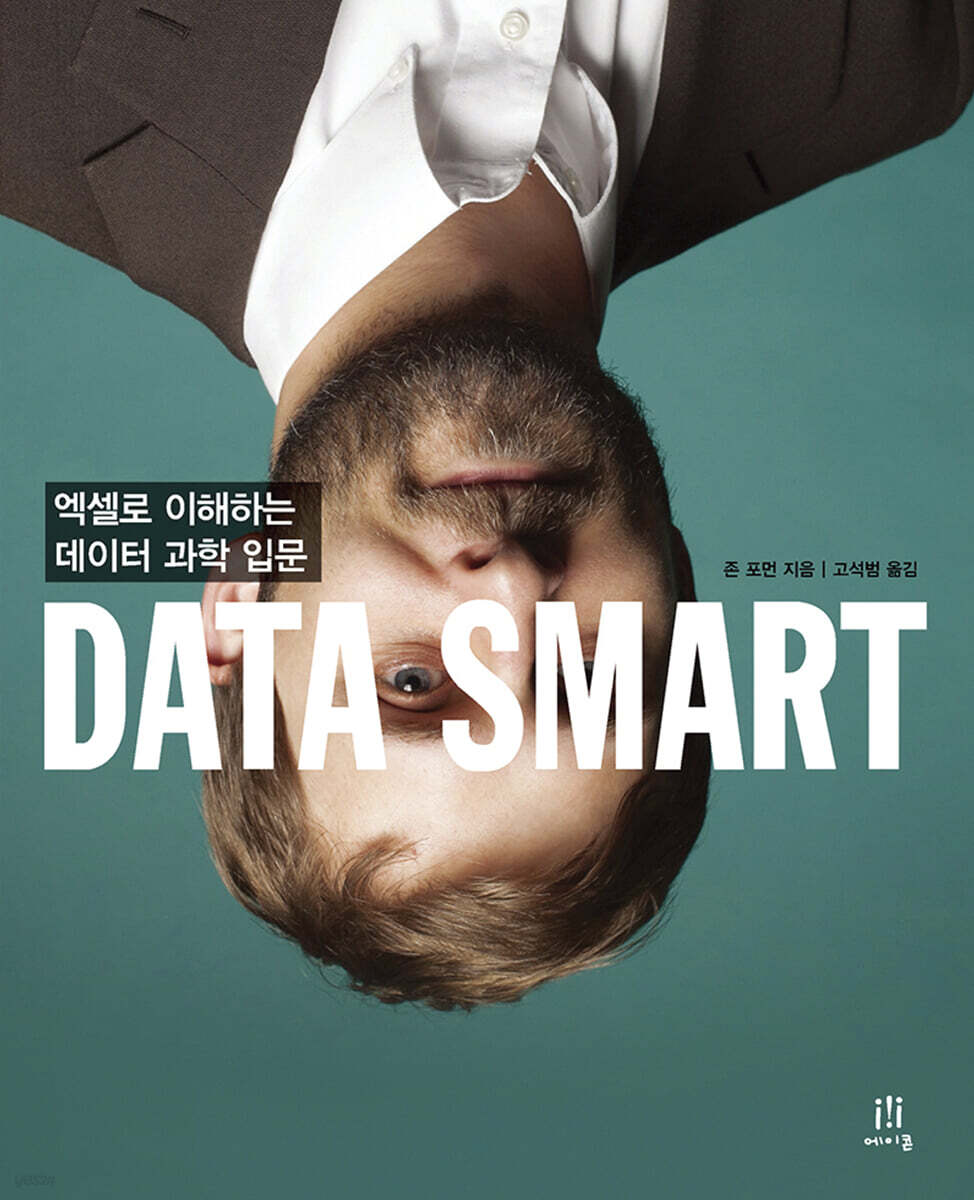
에이콘 데이터 과학 시리즈
상세 이미지

책소개
목차
|
1 스프레드시트에서 꼭 알아야 하지만, 감히 물어보지 못했던 것들
몇 개의 샘플 데이터 컨트롤 버튼으로 빠르게 이동 수식과 데이터를 빠르게 복사 셀 서식 선택 선택하여 붙여넣기 차트 삽입 찾기 및 바꾸기 값의 위치, 어떤 위치의 값을 다루는 수식 VLOOKUP을 사용하여 데이터 합치기 필터와 정렬 피벗 테이블 사용 배열 수식 사용 해 찾기로 문제 풀기 오픈솔버: 필요 없기를 바랬는데, 필요한 것 정리 2 군집분석 1: K-평균을 사용하여 고객 기반 세분화 여자 아이들은 여자 아이들과 춤을 추고, 남자 아이들은 발꿈치를 긁는다 실제 적용: K-평균 군집화로 이메일 마케팅에서의 고객 분류 제이 뱅 오도넛 와인 도매 상사 최초의 데이터 셋 측정할 대상 결정 4개의 군집으로 시작 유클리드 거리: 직선 거리 구하기 모든 고객에 대한 거리와 군집 할당 군집 중심점 계산 결과 이해 군집별 가장 많았던 거래 정보 얻기 실루엣: 서로 다른 K 값이 치고받을 수 있도록 하는 좋은 방법 5개의 군집은 어떤가? 다섯 개의 군집에서 해 찾기 5개 군집의 최고 거래 내용 보기 5-평균 군집화에서 실루엣 계산 k-중앙 군집화와 비대칭적인 거리 측정 k-중앙 군집화의 사용 더 적합한 거리 매트릭스 구하기 이 모든 것을 엑셀에 집어 넣기 5-중앙 군집법에서의 최고 거래 보기 정리 3 나이브 베이즈: 바보이기에는 너무나 민첩한 제품 이름을 맨드릴로 지으면 신호와 잡음을 동시에 얻는다 세상에서 가장 간단한 확률 이론 소개 조건부 확률 모두 합하기 결합 확률, 체인 규칙, 독립 종속적인 상황에서는 어떤 일이 벌어지는가? 베이즈의 정리 베이즈 규칙을 사용하여 인공지능 모델 만들기 높은 수준의 분류 확률은 종종 같다고 가정된다 추가로 고려할 잡다한 것들 엑셀 시작 불필요한 문장 부호 제거 빈칸을 사용하여 나누기 토큰의 개수와 확률 계산 모델을 가졌으므로 사용해 보자 정리 4 모델 최적화: 신선한 과즙이 자기 스스로 혼합되는 것은 아니기 때문에 데이터 과학자가 최적화를 알아야 하는 이유 간단한 균형점 잡기 문제로 시작 문제를 하나의 포트폴리오로 표현 레벨셋을 이동하여 문제 풀기 심플렉스 메소드: 코너에서 찾기 엑셀로 작업해 보기 이 장의 뒤쪽에 괴물이 있다 혼합 모델을 이용해 과수원에서 유리잔까지 유지되는 신선함 혼합 모델의 사용 몇 가지 스펙으로 시작하자 일관성으로 돌아와서 데이터를 엑셀에 넣기 해 찾기에 문제 설정 기준 낮추기 죽은 다람쥐 치우기: 미니맥스 공식 IF-Then과 Big M 제한 조건 변수들을 곱하기: 볼륨을 11로 키우기 리스크 모델링 정규분포하는 데이터 정리 5 군집분석 2: 네트워크 그래프와 커뮤니티 탐지 네트워크 그래프의 의미 간단한 그래프로 시각화 게피에 대한 간단한 소개 게피의 설치와 파일 준비 그래프 레이아웃 잡기 노드 등급 보기 좋게 인쇄 그래프 데이터 만지기 와인 도매 데이터로 그래프 만들기 코사인 유사도 행렬 만들기 r-네이버후드 그래프 만들기 에지의 가치는 얼마인가? 그래프 모듈성에서의 포인트와 벌점 무엇이 포인트이고 무엇이 벌점인가? 스코어 시트 설정 군집 나누기 분할 번호 1 Split 2: 일렉트릭 부갈루 그리고 Split3: 더 극단적으로 나누기 커뮤니티 인코딩과 분석 게피로 다시 돌아가기 정리 6 회귀: 인공지능 지도 학습법의 원조 잠깐만요, 뭐라고요? 임신이라고요? 웃기지 마라! 선형회귀를 사용하여 리테일마트에서 임신 고객 예측 특성들의 집합 훈련용 데이터 만들기 가변수 만들기 선형 회귀 모델을 만들어 보기 선형 회귀 통계: R-Squared, F 검정, t 검정 새로운 데이터에 대한 예측과 성능 측정 로지스틱 회귀를 사용하여 임신 고객 예측 먼저 링크 함수가 필요하다 로지스틱 함수와 다시 최적화 실제로 해 보는 로직스틱 회귀 모델 선택: 선형 회귀와 로지스틱 회귀의 비교 더 많은 정보 정리 7 앙상블 모델: 푸짐하게 준비된 맛없는 피자 6장의 데이터를 사용한다 배깅: 무작위, 훈련, 반복 결정 스텀프는 바보같은 예측인자에 대한 섹시하지 않은 용어다 내겐 그렇게 바보같아 보이지 않아요! 더 많은 힘이 필요하다! 훈련시키기 배깅 모델 평가 부스팅: 잘 안 되면 기운을 북돋고 다시 해 봐라! 모델 훈련: Every Feature Gets a Shot 부스팅 모델 평가 정리 8 예측: 안심해라, 뭘 해도 틀릴 수 있다 장검 장사가 잘 되고 있다 시계열 데이터에 익숙해지기 단순 지수 평활법으로 천천히 시작한다 단순 평활 예측법을 위한 설정 데이터에 경향성이 있다 홀트의 트렌드 반영 지수 평활법 홀트 트렌드 반영 지수 평활법을 스프레드시트에서 설정 다 되었는가? 자기 상관을 보자. 배수적 홀트 윈터스 지수 평활법 초기 레벨, 트렌드, 계절성 요인 값의 설정 예측 최적화 지금 우리가 한 것에 대해 이야기해 주세요! 예측 구간 삽입 팬 차트 만들기 정리 9 이상점 탐지: 이상해 보인다고 해서 진짜 이상한 것은 아니다 이상점은 (나쁜) 사람이 될 수도 있다 해들럼씨와 해들럼 부인의 논쟁 튜키 울타리 스프레드시트에서 튜키 울타리 적용 간단한 접근법의 한계 어떤 것에도 끔찍하지 않거나 모든 것에 나쁘다 그래프를 위한 데이터 준비 그래프 생성 k 최근접 이웃 구하기 그래프 이상점 탐지 방법 1: 내향등급 사용 그래프 이상점 탐지 방법 2: Getting Nuanced with k-Distance 그래프 이상점 탐색 방법 3: 지역 이상점 인자 정리 10 스트레드시트에서 R로 옮겨가기 R에 올라타기 손으로 주물러 보기 R로 데이터 읽기 R로 실제 데이터 과학하기 단지 몇 줄로 와인 데이터에 대한 구상 K-평균 구하기 임신 데이터에서 인공지능 모델 구축 R에서의 예측 이상점 탐지 정리 결론 나는 누구인가? 어떤 일이 있었는가? 더 나아가기 전에 문제의 본질에 다가서라 더 많은 중개자가 필요하다 머리 셋 달리 괴물을 직시해라: 도구, 성능, 수학적인 완성도 여러분은 여러분의 조직에서 가장 중요한 일을 하는 사람이 아니다 창의적으로 일하고 연결을 유지하자 |
저자 소개
저자 : 존 포먼 (John W. Foreman)
메일침프닷컴(MailChimp.com)의 수석 데이터 과학자다. 회복 경영 컨설턴트로 코카콜라, 로열캐리비언, 인터컨티넨털 호텔과 같은 대규모 사업체와 DoD, IRD, DHS, FBI와 같은 정부기관에서 데이터 분석 프로젝트를 해왔다. 사업체에서 데이터 분석 솔루션을 구축하는 방안이나 어려움들에 대해 자주 강연을 한다
.
John-Foreman.com을 보면 인근에서 열릴 강연 등을 찾을 수 있다. 데이터 작업을 하지 않을 때는 하이킹을 하거나 텔레비전을 보고, 온갖 맛없는 음식 등을 먹고, 세 명의 아들을 키운다.
.
John-Foreman.com을 보면 인근에서 열릴 강연 등을 찾을 수 있다. 데이터 작업을 하지 않을 때는 하이킹을 하거나 텔레비전을 보고, 온갖 맛없는 음식 등을 먹고, 세 명의 아들을 키운다.
역자 : 고석범
가톨릭대학교 의과대학을 졸업하고, 같은 대학 병원에서 수련을 받은 신경과 전문의다. 현재 보바스기념병원에서 근무하고 있고, 도서관장에서 시작하여 진료지원 부장, 성남시노인보건센터장, 병원장 등 보직을 두루 경험하면서, 의료 현장의 서비스 질, 생산성 향상을 고민해왔다. 문제를 해결할 수 있는 핵심 툴은 컴퓨터라는 것을 깨닫고, 늦게나마 컴퓨터를 공부하기 시작했다. 에이콘출판사에서 출간한 『R과 Knitr를 활용한 데이터 연동형 문서 만들기』(2014)을 집필했고, 『R과 Shiny 패키지를 활용한 웹 애플리케이션 개발』(2014)을 번역했다.
관련 분류
품목정보
- 발행일
- 2015년 07월 28일
- 쪽수, 무게, 크기
- 524쪽 | 989g | 188*235*25mm
- ISBN13
- 9788960777378
출판사 리뷰
|
아마존닷컴에서 평균 별점 5개로 독자들의 큰 호평을 받은 데이터 과학 입문서다. 누구나 사용하는 엑셀(Excel) 프로그램을 이용해 데이터 과학과 비즈니스 분석의 복잡한 알고리즘을 한눈에 보이듯 알려준다. "빅데이터가 중요하고 우리 회사도 도입한다고 하던데... 그게 뭐지?"라고 막연해 하는 실무 담당자들이나 "데이터 과학이 무엇이며, 왜 중요한 걸까?"라며 새로이 공부를 시작해 보려는 사람들에게 큰 도움이 되는 책이다.
아울러, 이미 웬만한 빅데이터 책은 여러 권 보았지만 단순한 기술 활용에서 별다른 영감을 얻지 못하는 이들에게 “어떻게 하면 빅데이터에서 통찰을 이끌어낼 수 있는지?”에 대한 새로운 출발점을 제공한다. 어렵지 않은 엑셀 예제들로 시작해 R로 마무리하며, 데이터 과학을 유쾌하고 쉬우며 재미있게 이해할 수 있게 해주는 흔치 않은 책이다. ★ 이 책에서 다루는 내용 ★ ■ 일반 선형 모델, 앙상블 모델, 나이브 베이즈 등을 사용한 인공지능 ■ k-평균, 구상 k-평균, 그래프 모듈성 등을 사용한 군집화 ■ 비선형 프로그래밍과 유전 알고리즘 등을 비롯한 최적화 ■ 시계열 데이터 작업과, 지수 평활법을 사용한 예측 방법 ■ 리스크를 정량화하기 위한 몬테카를로 시뮬레이션 ■ 단일 차원, 다차원에서 이상점 탐지 ■ 데이터 과학에 적합한 R 언어 탐구 ★ 이 책의 대상 독자 ★ 나는 이 책에 대한 전형적인 독자상(마케팅하는 사람들은 그것을 페르소나라고 부른다)을 다음과 같이 설정하고 글을 썼다. ■ 마케팅부의 부팀장으로 고객들의 거래 데이터를 전략적으로 사용해 가격과 고객 세그먼트를 결정하고자 한다. 그런데 소프트웨어 개발자들이나 비싼 컨설턴트들이 사용해 보도록 권하는 접근법을 제대로 이해하고 있지 않다. ■ 수요 예측 분석가로 회사의 과거 판매 데이터가 단순한 다음 분기 계획보다 더 가치가 있다는 사실을 잘 알고 있다. 그런데 그 가치를 뽑아내는 방법을 모른다. ■ 온라인 소매 스타트업의 사장으로 과거 고객들이 구매 데이터에 기반하여 언제 구매를 위해 그들이 지갑을 여는지 예측하고자 한다. ■ 경영정보 분석가로 회사의 기반 시설과 공급망 관리에 효율적으로 돈이 쓰이지 못하고 있다는 사실을 안다. 그럼에도 시스템적으로 어떻게 비용 절감 의사결정을 할지 모르겠다. ■ 온라인 마케터로 이메일, 페이스북, 트위터 등을 통해서 텍스트로 소통하는 고객들과 함께 더 많은 일을 하고 싶은데, 여러분은 그저 그것들을 읽고 저장하는 수준에 그치고 있다. 나는 여러분이 독자로서 데이터 과학에 대한 지식을 통해서 직접 이득을 취할 수 있기를 바라는데, 아직 모든 기술에 대한 기초는 갖추지 못했다고 가정할 것이다. 이 책의 목표는 데이터 과학과 관련된 여러 귀찮은 부분들(코드, 도구, 과장된 말들)을 걷어내고, 대학에서 한 학기 정도 선형 대수나 미적분학을 배운 사람이라면 충분히 이해할 수 있는 실용적인 예를 가지고 실질적인 테크닉을 가르치는 데 있다. 만약 대학에서 해당 과목을 F 학점 맞았다 하더라도 실망할 필요가 없다. 책을 천천히 읽거나 위키백과 등을 찾아보면 충분히 해결할 수 있다. ★ 이 책의 구성 ★ 1장에서는 잘 모를 수도 있는 엑셀의 이런 저런 기능들을 설명할 것이다. 이후 그 기능들을 활용하는 사례들로 넘어간다. 이 책이 끝날 쯤이면, 다음과 같은 기술들을 이해하고, 문제를 풀기 위해서 무엇을 해야 할지 알게 될 것이다. ■ 선형, 정수형 프로그래밍을 사용한 최적화 ■ 시계열 데이터를 다루고, 트렌드와 계절적 패턴을 감지하고, 지수 평활법을 사용하여 예측하는 방법 ■ 리스트를 계량화하여 시나리오를 예측하는 데 몬테카를로 시뮬레이션 사용하기 ■ 일반 선형 모델, 로지스틱 링크 함수, 앙상블(ensemble) 모델, 나이브 베이즈(naive bayes)에 기초한 인공지능 ■ 코사인 유사도를 사용하여 거리 구하기, kNN 그래프 만들기, 모듈성 계산하기, 고객 군집화하기 ■ 튜키 울타리를 사용하여 1차원에서 이상값 알아내기, 지역 이상값 인자를 사용하여 다차원에서 이상값 알아내기 ■ 거인의 어깨에 올라서는 것처럼 다른 분석가들이 개발한 R 패키지를 이용하는 방법 ★ 지은이의 말 ★ 여러분은 아마도 최근에 언론, 경영서적이나 잡지, 컨퍼런스 등에서 데이터 과학이라는 단어를 많이 들어왔을 것이다. 데이터 과학은 대통령 선거를 예측할 수 있고, 당신의 소비 습관을 여실히 보여주며, 칠리치즈부리또가 얼마나 인간 수명을 줄어들게 하는지도 예측할 수 있다. 이런 기술을 보유한 전문가 집단인 데이터 과학자들을 두고, 마치 유니콘을 섹시하다고 부르는 것처럼 그다지 적절한 표현 같지는 않아 보이지만, 최근 하버드비즈니스리뷰에서는 섹시한 직군이라고 평가했다. 그 주장을 증명할 아무런 방법도 없긴 하지만, 면도도 못하고 세 아이의 부모로 피곤한 눈을 하고 이 책을 타이핑하고 있는 나를 본다면 섹시하다는 말은 좀 과장된 표현임을 단박에 알 것이다. 화제를 돌려보자. 내가 이야기하고 싶은 요점은 최근에 데이터 과학에 대한 버즈(buzz)를 회자시켰고, 이와 같은 버즈는 수많은 비즈니스 업계에 압력으로 이어진다는 점이다. 이를테면 데이터 과학을 하지 않으면, 경쟁에서 밀린다는 식이다. 누군가가 ‘이러쿵저러쿵 빅데이터 어쩌구’라는 것을 새로 개발할 예정이고, 곧 여러분의 비즈니스를 파괴할 것이라는 식이다. 여기서, 숨을 길게 한 번 내쉬어 보라. 대부분의 사람들은 데이터 과학을 완전히 잘못 시작하고 있다. 일반적으로, 먼저 도구를 구매하고 컨설턴트를 고용하는 것으로 시작한다. 그들은 자신이 원하는 것이 무엇인지도 알기도 전에 거금을 투자한다. 요즈음 많은 회사에서 사람들이 발주서만 받고도 마치 실제 일이 진행된 것인 양 오인하는 경향이 있다. 이 책을 읽고 나면 이런 농담들을 다리 아래에 두고 내려다 보게 될 것이다. 이 책에서는 데이터 과학의 여러 기술들이 어떤 것이고, 어떻게 사용되는지 배울 것이기 때문이다. 언젠가 계획을 세우거나, 사람을 고용하거나, 뭔가를 사야 하는 시점이 왔을 때, 이미 여러분은 조직 안에서 데이터 과학에 대한 기회를 확인한 상태일 것이다. 이 책의 목적은 편안하고 대화하듯이 데이터 과학에서 하는 일들을 소개하는 것이다. 이 책을 다 읽고 난 후 데이터 과학에 대한 불안은 흥분과 데이터를 활용하여 여러분의 비즈니스를 한 단계 더 도약할 수 있게 하는 아이디어로 바뀔 수 있기를 희망한다. ★ 옮긴이의 말 ★ 엑셀로 시작하는 유쾌한 데이터 과학과 비즈니스 분석 입문 나는 원래 R의 열렬한 팬이다. 많은 R 사용자들이 그렇듯 오픈소스를 즐겨 사용하기 때문에 엑셀을 가지고 설명하는 책에 대한 번역은 선뜻 받아들이기 어려운 제안이었다. 그러나 아마존 서평들과 저자의 서문 등을 읽고서 저자의 의도를 이해하고 나니 마음이 많이 바뀌었다. 저자가 엑셀이라는 가장 흔한 도구를 꺼내 들고 데이터 과학을 설명하는 데는 여러 가지 이유가 있다. ‘빅데이터’라는 단어는 이젠 흔하게 듣는다. 주된 업무가 데이터 분석인 데이터 과학자들은 물론이고, 나 같은 일반 대중들까지도 막연하게나마 중요하고 실생활에 유용하다는 감을 가지게 되었다. 여러 미디어를 통해 들려오는 소식만 들어도, 뭔지는 잘 모르겠지만 중요하다고 세뇌될 정도이다. 이 책은 그런 ‘빅데이터’ 기술을 뒷받침하는 ‘데이터 과학’ 입문서다. 데이터 과학은 그 자체가 융복합 학문이다. 그 이론적 배경을 뒷받침하는 통계학, 이론을 구체적인 형태로 구현할 수 있게 해주는 컴퓨터 과학, 가설을 세우고 실험을 통해 검증하는 과학 본연의 방법론 등이 데이터 과학이라는 말 속에 녹아 있다. 융복합적인 특성은 참 매력적으로 보인다. 이렇듯 중요하고 새로운 오일로 비유되는 데이터 과학을 막상 이해하려고 달려들면 수학, 통계학, 프로그래밍에 능통하지 않는 한 결코 쉽지 않다. 수학 공식들이 나오기 시작하면 포기하고 싶고, 뭔가 직관적인 설명을 해주는 책이 더 없을까 찾아보게 된다. R 언어 같은 프로그래밍 언어, 하둡, NoSQL 등과 같은 내용까지 나오면 정말 눈앞이 깜깜하다. 데이터 과학을 다루는 책은 적지 않다. 그러나 대부분 책은 솔직히 나 같은 비전공자에겐 꽤 어려웠다. 이 책의 장점은 ‘쉽다’는 점이다. 무엇보다 이 책은 컴퓨터를 쓰는 사람이라면 어느 정도는 아는 엑셀을 가지고 설명한다. 이런 접근법은 R이나 파이썬 같은 프로그램 언어를 배울 필요 없이 데이터 과학을 시작할 수 있게 해 준다. 그러면서 저자는 데이터 과학을 이야기할 때 지나치게 데이터 과학 자체보다는 어떤 기술적 논의로 흐르는 경향을 비판한다. 널려 있는 엑셀로도 데이터 과학은 얼마든지 가능하다고 말하는 것이다. 무엇이 앞에 있고, 무엇이 뒤에 있는지 제대로 보고 가야 한다고 충고한다. 그리고 저자는 손에 잡히는 데이터를 가지고 데이터 과학을 설명한다. 일상에서 들어봤을 것 같은 이야기를 가지고 설명해서 독자들의 이해를 돕는다. 그러면서 데이터 과학에서 다루는 정말 다양한 기술들을 소개한다. 포괄적인 내용을 다루면서도 맥락을 잘 설명한다는 느낌을 받았다. 예를 들어, 내 경험에 의하면 몬테카를로 방법은 이해하기 쉬운 주제가 아니다. 인터넷에 수많은 자료들이 있지만, 시원하게 풀어주는 것은 없었다. 그렇지만 이 책의 경우 두 군데 정도에서 이 기법을 사용하는데, 그것을 보면서 훨씬 쉽게 다가갈 수 있었다. 시계열 분석과 예측 문제도 비슷했다. 사용되는 엑셀 언어는 약간은 고급 기술이지만, 충분히 이해될 정도다. 또 그냥 알아둬도 일상적인 업무에서 유용하게 쓸 수 있는 재미있는 기술들을 소개하고 있다. 새로운 프로그래밍 언어를 배울 때면 가장 먼저 그 언어로 “Hello, World!”를 인쇄해 보는 프로그래밍을 만들어 보게 된다. 이런 첫 번째 코드를 실행하고 나면 특이한 설렘이 생긴다. 그 느낌은 유럽 배낭 여행을 위해 첫 시작인 런던행 비행기에서의 기분과 비슷하다. 할까 말까 고민도 많았는데, 결국 비행기에 올랐고, 이제는 정말 해야 되는 상황으로 기대와 설렘, 걱정 등이 뒤섞여 있는 기분이다. 그 느낌으로 난 이 책을 “Hello, Data Science World!”라고 말하고 싶다. 그리고 내가 이 책의 느낌을 잘 살려 번역했기를 바란다. |