

- 국내배송만 가능
- 예약상품과 함께 주문 시 제품 출시일에 함께 배송됩니다. (제작사의 사정으로 출시 지연 가능)
- 문화비소득공제 가능
이 상품의 태그
상세 이미지

책소개
목차
|
옮긴이 머리말 xi
추천 서문(게리트 카츠마이어) xiii 추천 서문(라구 라마크리슈난) xiv 추천 서문(릭 시어스) xv 시작하며 xvii 표지에 대하여 xxi PART I 아파치 아이스버그 기초 CHAPTER 1 아파치 아이스버그 소개 3 1.1 어떻게 여기까지 오게 되었나? 간단한 역사 3 1.2 데이터 웨어하우스 7 1.3 데이터 레이크 11 1.4 데이터 레이크에서 분석을 실행해야 할까, 아니면 데이터 웨어하우스에서 실행해야 할까? 15 1.5 데이터 레이크하우스 16 1.6 테이블 형식이란 무엇인가? 18 1.7 하이브: 태초의 테이블 형식 19 1.8 모던 데이터 레이크 테이블 형식 22 1.9 아파치 아이스버그란 무엇인가? 23 1.10 요약 30 CHAPTER 2 아파치 아이스버그 아키텍처 31 2.1 데이터 계층 32 2.2 메타데이터 계층 36 2.3 카탈로그 43 2.4 요약 44 CHAPTER 3 쓰기 및 읽기 쿼리의 라이프사이클 45 3.1 아파치 아이스버그에서의 쓰기 쿼리 46 3.2 아파치 아이스버그에서의 읽기 쿼리 58 3.3 요약 66 CHAPTER 4 아이스버그 테이블 성능 최적화하기 67 4.1 압착 67 4.2 압착 실습하기 69 4.3 정렬 77 4.4 z-order 81 4.5 파티셔닝 84 4.6 copy-on-write 대 merge-on-read 89 4.7 기타 고려 사항 95 4.8 요약 103 CHAPTER 5 아이스버그 카탈로그 104 5.1 요구 사항 104 5.2 카탈로그 비교 105 5.3 카탈로그 마이그레이션 114 5.4 요약 121 PART II 아파치 아이스버그 실제로 사용해 보기 CHAPTER 6 아파치 스파크 125 6.1 설정하기 125 6.2 데이터 정의 언어 133 6.3 데이터 읽기 144 6.4 데이터 쓰기 148 6.5 아이스버그 테이블 유지보수하기 153 6.6 요약 155 CHAPTER 7 드레미오의 SQL 쿼리 엔진 156 7.1 설정하기 156 7.2 데이터 정의 언어 158 7.3 데이터 읽기 162 7.4 데이터 쓰기 164 7.5 아이스버그 테이블 유지보수하기 166 7.6 요약 168 CHAPTER 8 AWS Glue 169 8.1 설정하기 169 8.2 Glue 데이터 카탈로그를 사용하여 테이블 생성하기 173 8.3 요약 175 CHAPTER 9 아파치 플링크 176 9.1 설정하기 176 9.2 데이터 정의 언어 179 9.3 데이터 읽기 185 9.4 데이터 쓰기 187 9.5 플링크 DataFrame 및 Table API와 아파치 아이스버그 테이블 189 9.6 요약 195 PART III 실전에서 아파치 아이스버그 사용하기 197 CHAPTER 10 프로덕션 환경에서의 아파치 아이스버그 199 10.1 아파치 아이스버그 메타데이터 테이블 200 10.2 브랜치를 사용해서 변경 사항 격리하기 227 10.3 다중 테이블 트랜잭션 234 10.4 변경 사항 롤백하기 236 10.5 요약 241 CHAPTER 11 아파치 아이스버그로 스트리밍하기 243 11.1 스파크를 사용해서 스트리밍하기 244 11.2 플링크를 사용해서 스트리밍하기 250 11.3 카프카 커넥트를 사용해서 스트리밍하기 259 11.4 AWS로 스트리밍하기 264 11.5 요약 268 CHAPTER 12 거버넌스와 보안 269 12.1 데이터 파일 보안 270 12.2 의미 체계 계층에서의 보안 및 관리 284 12.3 카탈로그 수준에서 보안 및 관리 291 12.4 추가적인 보안 및 거버넌스 고려 사항 297 12.5 요약 298 CHAPTER 13 아파치 아이스버그로 마이그레이션하기 299 13.1 마이그레이션 고려 사항 300 13.2 하이브 테이블을 아파치 아이스버그로 마이그레이션하기 303 13.3 델타 레이크를 아파치 아이스버그로 마이그레이션하기 305 13.4 아파치 후디를 아파치 아이스버그로 마이그레이션하기 306 13.5 개별 파일을 아파치 아이스버그로 마이그레이션하기 307 13.6 데이터를 다시 써서 임의의 위치에서 마이그레이션하기 309 13.7 요약 314 CHAPTER 14 아파치 아이스버그의 실제 활용 사례 316 14.1 아파치 아이스버그에서 Write-Audit-Publish를 사용하여 데이터 품질 보장하기 316 14.2 데이터 레이크에서 BI 워크로드 실행하기 325 14.3 아파치 아이스버그로 CDC 구현하기 330 14.4 요약 338 찾아보기 340 |
저자 소개 4
오픈 데이터 레이크하우스 플랫폼 드레미오(Dremio)의 창업자이자 최고 제품 책임자(CPO)다. 드레미오 창업 전에는 빅데이터 분석 분야의 선구 기업인 MapR의 부사장을 지냈으며, 마이크로소프트와 IBM 리서치에서 제품 관리 및 엔지니어링 업무를 수행했다. 수십만 명의 유료 고객을 확보한 여러 웹 기반 서비스를 설립했으며, 다양한 산업 분야를 주제로 저술과 강연 활동도 활발히 하고 있다.
현재 드레미오의 기술 전도 총괄 디렉터이며, 이전에는 제품 디렉터, 기술 디렉터, 선임 솔루션 아키텍트를 역임했다. 10년 이상 데이터 및 IT 분야에서 활동했으며, 고객과 개발자가 스스로 문제를 해결하고 성공할 수 있도록 돕는 일에 큰 열정을 갖고 있다.
드레미오의 개발자 전도사로, 이전에는 GenEd Systems 등에서 개발자와 강사로 활동했다. 기술 전파에 대한 열정이 커서 블로그, 동영상, 팟캐스트 등을 통해 다양한 기술 콘텐츠를 꾸준히 발행하고 있다. 여러 대형 기술 콘퍼런스에서 발표했으며, 자바스크립트/파이썬 생태계의 다양한 오픈소스 라이브러리 개발에도 기여했다.
네이버에서 사내 카프카 서비스를 개발하고 있으며, 관련 프로젝트의 사내 배포판 작업 역시 담당하고 있다. 오랫동안 빅데이터 관련 작업을 해오면서 그만큼 많은 관련 프로젝트에 다양한 기여를 해 왔다. 아파치 카프카에서는 압축 관련 기능, 아파치 스파크와의 레코드 헤더 연동 기능 등을 개발했다.
이동진의 다른 상품
품목정보
책 속으로
|
아파치 아이스버그 프로젝트는 데이터 레이크하우스 테이블을 정의하는 메타데이터가 여러 파일에 걸쳐 어떻게 작성되어야 하는지를 정의하는 스펙(specification) 내지 표준이라고 할 수 있다. 이 표준을 확산시키기 위해 아파치 아이스버그는 사용자가 해당 형식을 다루거나 연산 엔진이 지원 기능을 구현할 수 있도록 해주는 여러 라이브러리를 포함한다. 이러한 라이브러리와 함께, 프로젝트는 아파치 스파크나 아파치 플링크와 같은 오픈소스 연산 엔진에 대한 구현체도 만들었다. (…) 어떤 툴을 사용하든 사용자는 테이블 작업을 한다는 사실만 알면 될 뿐, 그 이상은 생각할 필요가 없다.
--- pp.24-25 데이터베이스와 데이터 웨어하우스의 세계에서 중요한 기능 중 하나는 테이블의 특정 상태로 시간을 거슬러 올라가서 과거 데이터(즉, 변경되거나 삭제된 데이터)를 쿼리할 수 있는 기능이다. 아파치 아이스버그는 데이터 레이크하우스 아키텍처에 이와 유사한 시간 여행 기능을 제공한다. 이는 조직의 이전 분기의 데이터를 분석하거나, 실수로 삭제된 행을 복구하거나, 분석 결과를 재현하는 등의 시나리오에서 특히 유용할 수 있다. 아파치 아이스버그는 시간 여행 쿼리를 실행하는 방법으로 두 가지 방법, 즉 타임스탬프를 사용하는 방법과 스냅샷 ID를 사용하는 방법을 제공한다. --- p.62 register_table()과 비슷하게, snapshot() 스파크 SQL 프로시저는 소스 테이블의 데이터 파일을 사용하여 소스 테이블의 가벼운 복사본을 생성한다. 그러나 register_table()과 달리, 대상 카탈로그의 테이블에 대한 변경 사항은 대상 테이블의 테이블 위치에 적용된다. 대상 테이블에 대한 변경이 소스 테이블과 서로 간섭하지 않는 것이다. 즉, 소스 테이블에 대한 변경 사항은 대상 테이블의 사용자에게 표시되지 않으며, 반대로 대상 테이블에 대한 변경 사항 역시 소스 테이블의 사용자에게 표시되지 않는다. --- p.120 하이브 한정 매개변수를 사용해서 아파치 아이스버그 테이블을 설정할 때 고려해야 할 핵심 속성들이 몇 개 있다. 'uri' 속성은 하이브 메타스토어의 Thrift URI를 지정하며, 하이브 메타스토어와의 연결을 설정하는 데 필수적이다. 'clients' 속성은 선택 사항이지만, 하이브 메타스토어 클라이언트의 풀 크기를 지정할 수 있다(기본값은 2). 마지막으로 'warehouse' 속성은 하이브 기반 아이스버그 카탈로그와 관련된 메타데이터 및 데이터 파일이 저장될 위치를 지정하는 중요한 속성이다. 이 매개변수는 Flink SQL 환경에서 하이브와 통합될 때 아이스버그 카탈로그의 동작을 상세 설정하는 데 있어 중요한 역할을 한다. --- p.182 스파크의 DataSourceV2 API는 데이터 엔지니어들이 정형화되고 규모 확장적 방식으로 테이블에서 데이터를 읽거나 쓸 수 있도록 해준다. / 스파크 3 기준, Spark Structured Streaming(스파크의 SQL 기반 스트리밍 API)에서 아이스버그와 스파크의 DataFrame 읽기, 쓰기 기능은 서로 완전히 호환된다. 이 통합의 주요 기능 중 하나는 과거 타임스탬프로부터 처리를 시작하는 증분 데이터 처리 지원이다. 아이스버그 테이블에서 스트리밍 읽기를 할 경우에는 append 스냅샷만 지원된다. / 스파크의 DataStreamWriter는 스트리밍 방식으로 아이스버그 테이블에 데이터를 써넣는 데 사용된다. 아이스버그는 두 가지 출력 모드를 지원한다. append 모드는 각 마이크로배치의 행을 테이블에 추가하며, complete 모드는 각 마이크로배치마다 테이블의 내용을 완전히 대체한다. --- p.246 아파치 아이스버그로의 마이그레이션은 더 간결한 데이터 아키텍처를 약속하지만, 마이그레이션 과정 자체는 다른 마이그레이션과 마찬가지로 복잡하고 어려운 작업일 수 있다. 이 전환 과정에 는 기존 데이터 구조를 조정하고, 데이터 수집 파이프라인을 수정하며, 데이터 처리 워크플로를 업 데이트하는 것이 포함된다. 또한 조직은 기존 데이터 모델을 리팩터링하고 아이스버그에 호환되는 형식으로 데이터 저장 구조를 재구성해야 할 수도 있다. 마이그레이션은 또한 하위 호환성 문제에 대응하고 기존 데이터가 새로운 아키텍처와 원활하게 통합되도록 보장할 필요가 있다. 이 장에서는 이러한 문제들에 효과적으로 대응하기 위한 모범 사례들과 전략을 살펴볼 것이다. --- pp.299-300 |
출판사 리뷰
|
데이터 레이크를 진짜 데이터 플랫폼으로 만드는 핵심 기술, 아파치 아이스버그
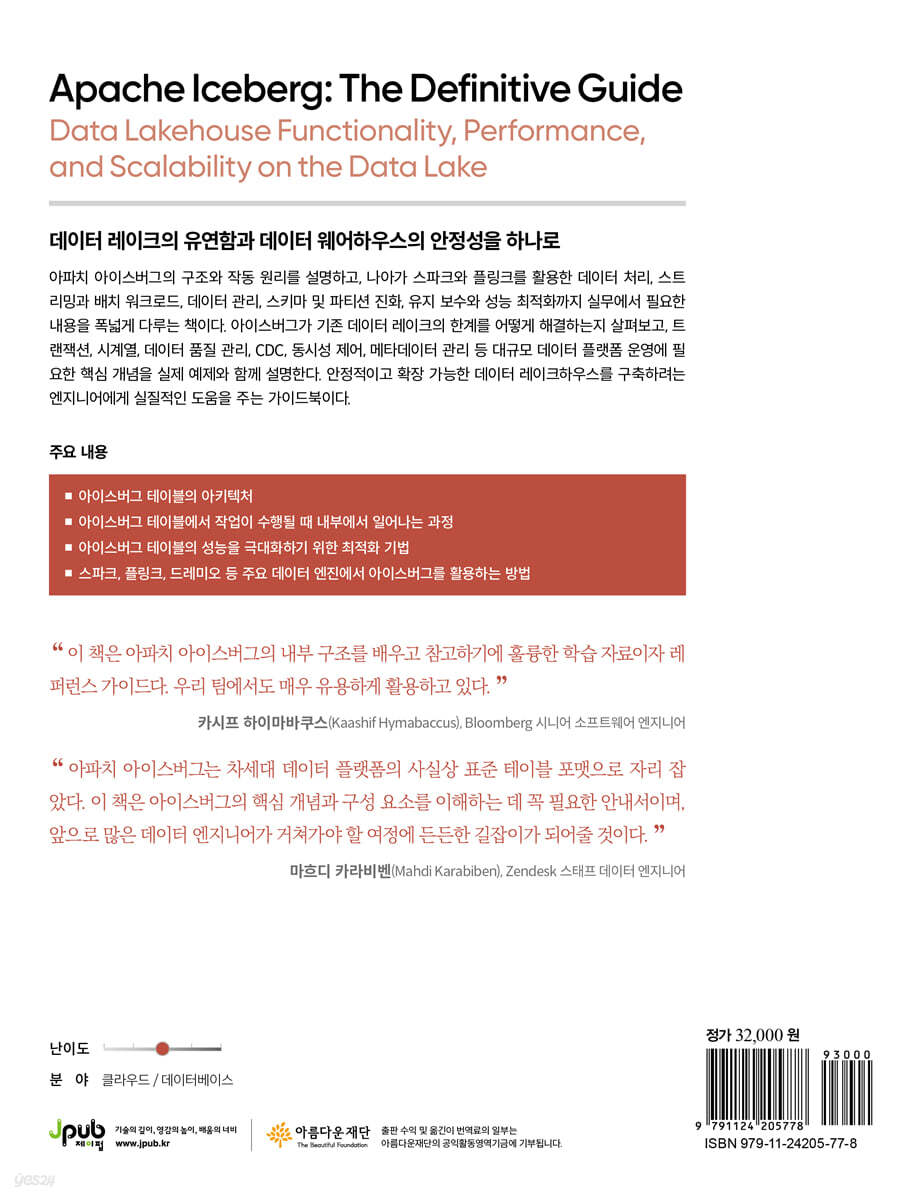
데이터 레이크는 저렴한 비용으로 방대한 데이터를 유연하게 저장할 수 있지만, 데이터 웨어하우스처럼 안정적인 트랜잭션과 높은 쿼리 성능을 제공하기는 쉽지 않다. 이러한 두 세계의 장점을 결합한 데이터 레이크하우스가 주목받으면서 그 기반 기술인 오픈 테이블 형식, 그중에서도 아파치 아이스버그의 중요성이 빠르게 커지고 있다. 이 책은 데이터 웨어하우스와 데이터 레이크가 어떻게 발전해 왔는지부터 출발해 테이블 형식이 왜 필요한지를 설명하고, 아이스버그가 데이터 파일과 메타데이터, 매니페스트, 스냅샷, 카탈로그를 이용해 대규모 데이터를 어떻게 관리하는지 내부 구조까지 차근차근 파고든다. INSERT, MERGE, SELECT 같은 작업이 내부에서 어떤 과정을 거치는지를 따라가다 보면 아이스버그의 트랜잭션과 시간 여행, 스키마 및 파티션 진화가 어떻게 가능한지도 자연스럽게 이해할 수 있다. 성능과 운영에 관한 내용도 충실하다. 압착, 정렬, z-order, 숨겨진 파티셔닝, copy-on-write와 merge-on-read, 메트릭과 매니페스트 관리 등 아이스버그 테이블의 성능을 끌어올리는 방법을 구체적으로 설명한다. 이어 스파크, 드레미오, AWS Glue, 플링크를 이용해 테이블을 생성하고 읽고 쓰며 유지보수하는 방법을 실제 코드와 함께 살펴본다. 특정 엔진 하나에 종속되지 않는 아이스버그의 장점을 직접 확인할 수 있는 구성이다. 책의 후반부에서는 아이스버그를 프로덕션에서 어떻게 운영할 것인가에 집중한다. 메타데이터 테이블을 활용한 상태 확인, 브랜치와 태그를 이용한 변경 사항 격리, 다중 테이블 트랜잭션과 롤백을 비롯해 스트리밍, 데이터 거버넌스와 보안, 그리고 마이그레이션까지 폭넓게 다룬다. 이어서 데이터 품질을 보장하는 Write-Audit-Publish, 데이터 레이크에서의 BI 워크로드, 변경 데이터 캡처(CDC) 등 실제 사례를 통해 앞에서 배운 기능들이 현실의 데이터 아키텍처에서 어떻게 결합되는지를 보여준다. 데이터 레이크하우스를 구축하려는 데이터 엔지니어, 데이터 플랫폼 개발자, 분석 엔지니어는 물론, 데이터 레이크하우스와 오픈 테이블 형식이 왜 현대 데이터 인프라의 핵심으로 떠오르고 있는지 제대로 이해하고 싶은 독자에게도 탄탄한 이론과 실무 지식으로 도움을 주는 길잡이 같은 책이다. 주요 내용 · 아이스버그 테이블의 아키텍처 · 아이스버그 테이블에서 작업이 수행될 때 내부에서 일어나는 과정 · 아이스버그 테이블의 성능을 극대화하기 위한 최적화 기법 · 스파크, 플링크, 드레미오 등 주요 데이터 엔진에서 아이스버그를 활용하는 방법 |
추천평
|
이 책은 아파치 아이스버그의 내부 구조를 배우고 참고하기에 훌륭한 학습 자료이자 레퍼런스 가이드다. 우리 팀에서도 매우 유용하게 활용하고 있다. - 카시프 하이마바쿠스(Kaashif Hymabaccus) (Bloomberg 시니어 소프트웨어 엔지니어)
|
|
아파치 아이스버그는 차세대 데이터 플랫폼의 사실상 표준 테이블 포맷으로 자리 잡았다. 이 책은 아이스버그의 핵심 개념과 구성 요소를 이해하는 데 꼭 필요한 안내서이며, 앞으로 많은 데이터 엔지니어가 거쳐가야 할 여정에 든든한 길잡이가 되어줄 것이다 - 마흐디 카라비벤(Mahdi Karabiben) (Zendesk 스태프 데이터 엔지니어)
|
사락 별점0
혜택 및 유의사항밑줄0
혜택 및 유의사항
28,800원
총 1개
28,800원
