

소득공제
분철
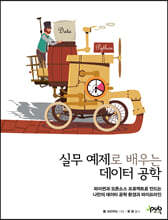
실무 예제로 배우는 데이터 공학
파이썬과 오픈소스 프로젝트로 만드는 나만의 데이터 공학 환경과 파이프라인
이미 소장하고 있다면 판매해 보세요.
- 국내배송만 가능
- 분철옵션 선택 시, 배송일이 변경될 수 있습니다.
- 분철상품은 해외배송이 불가합니다.
- 문화비소득공제 가능
이 상품의 태그


상세 이미지

책소개
목차
|
PART I 데이터 파이프라인 구축: 추출, 변환, 적재 1
CHAPTER 1 데이터 공학이란? 3 1.1 데이터 공학자가 하는 일 3 1.2 데이터 공학 대 데이터 과학 7 1.3 데이터 공학 도구들 7 1.4 요약 13 CHAPTER 2 데이터 공학 기반구조 구축 15 2.1 아파치 NiFi의 설치와 설정 16 2.2 아파치 에어플로의 설치와 설정 24 2.3 일래스틱서치의 설치와 설정 30 2.4 키바나의 설치와 설정 31 2.5 PostgreSQL의 설치와 설정 36 2.6 pgAdmin 4 설치 37 2.6.1 pgAdmin 4 둘러보기 38 2.7 요약 CHAPTER 3 파일 읽고 쓰기 41 3.1 파이썬으로 파일 쓰고 읽기 41 3.2 아파치 에어플로 데이터 파이프라인 구축 51 3.3 NiFi 처리기를 이용한 파일 다루기 57 3.4 요약 68 CHAPTER 4 데이터베이스 다루기 69 4.1 파이썬을 이용한 관계형 데이터 삽입 및 추출 70 4.2 파이썬을 이용한 NoSQL 데이터베이스 데이터 삽입 및 추출 79 4.3 데이터베이스를 위한 아파치 에어플로 데이터 파이프라인 구축 87 4.4 NiFi 처리기를 이용한 데이터베이스 처리 91 4.4.1 PostgreSQL에서 데이터 추출 92 / 4.4.2 데이터 파이프라인 실행 95 4.5 요약 96 CHAPTER 5 데이터의 정제, 변환, 증강 99 5.1 파이썬을 이용한 탐색적 데이터 분석 100 5.2 pandas를 이용한 공통적인 데이터 문제점 처리 109 5.3 에어플로를 이용한 데이터 정제 119 5.4 요약 122 CHAPTER 6 실습 프로젝트: 311 데이터 파이프라인 만들기 123 6.1 데이터 파이프라인 구축 123 6.2 키바나 대시보드 만들기 132 6.3 요약 142 PART II 실무 환경 데이터 파이프라인 배치 145 CHAPTER 7 실무용 데이터 파이프라인의 특징 147 7.1 데이터의 스테이징과 검증 148 7.2 멱등적 데이터 파이프라인 구축 168 7.3 원자적 데이터 파이프라인 구축 169 7.4 요약 171 CHAPTER 8 NiFi 레지스트리를 이용한 버전 관리 173 8.1 NiFi 레지스트리의 설치과 설정 173 8.2 NiFi에서 레지스트리 사용 176 8.3 데이터 파이프라인 버전 관리 178 8.4 NiFi 레지스트리에서 git-persistence 활용 184 8.5 요약 188 CHAPTER 9 데이터 파이프라인 모니터링 189 9.1 NiFi GUI를 이용한 데이터 파이프라인 모니터링 189 9.2 NiFi 처리기를 이용한 데이터 파이프라인 모니터링 198 9.3 파이썬과 REST API를 이용한 데이터 파이프라인 모니터링 201 9.4 요약 206 CHAPTER 10 데이터 파이프라인 배치 207 10.1 실무 배치를 위한 데이터 파이프라인 마무리 작업 207 10.2 NiFi 변수 레지스트리 활용 214 10.3 데이터 파이프라인 배치 217 10.4 요약 222 CHAPTER 11 실습 프로젝트: 실무용 데이터 파이프라인 구축 223 11.1 검사 환경과 실무 환경 구축 223 11.2 실무용 데이터 파이프라인 구축 227 11.3 데이터 파이프라인을 실무 환경에 배치 238 11.4 요약 238 PART III 일괄 처리를 넘어서: 실시간 데이터 파이프라인 구축 241 CHAPTER 12 아파치 카프카 클러스터 구축 243 12.1 주키퍼 및 카프카 클러스터 생성 243 12.2 카프카 클러스터 시험 운영 248 12.3 요약 250 CHAPTER 13 카프카를 이용한 데이터 스트리밍 251 13.1 로깅의 기초 251 13.2 카프카의 로그 활용 방식 253 13.3 카프카와 NiFi를 이용한 데이터 파이프라인 구축 257 13.4 스트림 처리와 일괄 처리의 차이 264 13.5 파이썬을 이용한 메시지 생산 및 소비 266 13.6 요약 270 CHAPTER 14 아파치 스파크를 이용한 데이터 처리 271 14.1 아파치 스파크의 설치와 설정 271 14.2 PySpark의 설치와 설정 275 14.3 PySpark를 이용한 데이터 처리 277 14.4 요약 283 CHAPTER 15 MiNiFi, 카프카, 스파크를 이용한 실시간 엣지 데이터 처리 285 15.1 MiNiFi 설치 및 설정 285 15.2 MiNiFi 데이터 파이프라인 구축 및 연동 288 15.3 요약 293 APPENDIX A NiFi 클러스터 구축 295 |
저자 소개 2
Paul Crickard
폴 크리커드는 《Leaflet.js Essentials: Community Experience Distilled》(2014, Packt)의 저자이자 《Mastering Geospatial Analysis with Python》(2018, Packt)의 공동 저자이며, 미국 뉴멕시코 주 앨버커키에 소재한 제2지방검찰청의 최고 정보 책임자(CIO)로 있다.
정치학 석사 학위 소지자이면서 공동체 및 지역 개발 경력을 지닌 저자는 사회과학 이론과 기법을 기술 프로젝트와 접목하는 전문가이기도 하다. ‘New Mexico Big Data and Analytics Summit’과 ‘Expe
폴 크리커드는 《Leaflet.js Essentials: Community Experience Distilled》(2014, Packt)의 저자이자 《Mastering Geospatial Analysis with Python》(2018, Packt)의 공동 저자이며, 미국 뉴멕시코 주 앨버커키에 소재한 제2지방검찰청의 최고 정보 책임자(CIO)로 있다.
정치학 석사 학위 소지자이면서 공동체 및 지역 개발 경력을 지닌 저자는 사회과학 이론과 기법을 기술 프로젝트와 접목하는 전문가이기도 하다. ‘New Mexico Big Data and Analytics Summit’과 ‘Experience IT NM Conference’에 참여했고, ‘New Mexico Big Data Working Group’, ‘Sandia National Labs’, ‘New Mexico Geographic Information Council’에서 강연자로 나서기도 했다.
정치학 석사 학위 소지자이면서 공동체 및 지역 개발 경력을 지닌 저자는 사회과학 이론과 기법을 기술 프로젝트와 접목하는 전문가이기도 하다. ‘New Mexico Big Data and Analytics Summit’과 ‘Experience IT NM Conference’에 참여했고, ‘New Mexico Big Data Working Group’, ‘Sandia National Labs’, ‘New Mexico Geographic Information Council’에서 강연자로 나서기도 했다.
도널드 커누스 교수의 《컴퓨터 프로그래밍의 예술》 시리즈를 비롯해 다양한 IT 전문서를 번역한 전문 번역가이다. 생성형 AI 관련 번역서로는 《마스터링 트랜스포머》 《실전! RAG 기반 생성형 AI 개발》 《LLM 인 프로덕션》 《AI 에이전트 인 액션》 등이 있다. 개인 웹사이트 류광의 번역 이야기(https://occamsrazr.net)와 IT 및 게임 개발 정보 공유 사이트 GpgStudy.com(https://gpgstudy.com)을 운영한다
류광의 다른 상품


품목정보
- 발행일
- 2021년 07월 20일
- 쪽수, 무게, 크기
- 336쪽 | 188*245*19mm
- ISBN13
- 9791191600148
책 속으로
|
가장 낮은 수준에서 데이터 공학에는 데이터를 한 시스템에서 다른 시스템으로 이동하거나 다른 형식(format)으로 변환하는 작업이 관여한다. 좀 더 일반적인 용어로 말하자면, 데이터 공학자는 자료원, 즉 데이터 공급원에서 데이터를 질의하고(‘추출’), 데이터를 어떤 방식으로든 수정하고(‘변환’), 데이터를 사용자가 접근할 수 있는, 그리고 거기에 있는 데이터가 실무 품질임을 아는 어떤 장소에 넣는다(‘적재’). 추출(extract), 변환(transform), 적재(load)라는 용어들은 이 책 전체에 쓰이며, 종종 ETL로 줄여서 표기하기도 한다. 그런데 데이터 공학의 이러한 정의는 다소 광범위하고 단순화된 것이다. 그럼 데이터 공학자가 과연 어떤 일을 하는지를 예제를 통해서 좀 더 깊게 살펴보자.
--- p.4 데이터 공학자는 효율적인 데이터 전송을 위해 데이터 형식, 모형, 구조를 고민하는 반면, 데이터 과학자는 그런 데이터를 활용해서 통계 모형을 구축하고 수학 계산을 수행하는 방법을 고민한다. 데이터 과학자는 데이터 공학자가 만든 데이터 웨어하우스에 연결해서 기계학습 모형과 분석에 필요한 데이터를 추출한다. 데이터 과학자가 자신의 모형들을 데이터 공학 파이프라인에 집어넣는 경우도 있다. 그런 만큼 데이터 공학자와 데이터 과학자는 밀접한 관계를 맺어야 한다. 데이터 과학자가 데이터에서 무엇을 필요로 하는지를 파악하는 것은 데이터 공학자가 더 나은 제품을 제공하는 데 도움이 된다. --- p.7 아파치 에어플로에서 DAG(Directed Acyclic Graph; 유향 비순환 그래프)를 만들 때에는 Bash 스크립트를 비롯해 다양한 연산자(operator)로 작업(task)을 정의할 수 있다. 이 책에서 특히 중요한 것은 파이썬 함수의 형태로도 작업을 정의할 수 있다는 점이다. 이 작업들은 DAG 형태로 조직화된다. 이는 작업들의 의존 관계와 실행 순서가 명시적으로 정의된다는 뜻이다. 여러 작업으로 DAG를 만든 다음에는 스케줄러를 이용해서 DAG의 실행 시점과 주기를 설정한다. 에어플로는 DAG를 감시하고 관리할 수 있는 GUI를 제공한다. 이번 절에서는 지금까지 배운 것을 이용해서 에어플로에서 데이터 파이프라인을 하나 만들어 본다. --- p.51 데이터 레이크data lake의 로그 파일이나 기타 텍스트 파일을 읽어서 데이터베이스나 데이터 웨어하우스로 옮기는 것은 데이터 공학자가 흔히 하는 작업이다. 이번 장에서는 제3장에서 배운 텍스트 파일 처리 기술에 기초해서 데이터를 데이터베이스로 옮기는 방법을 살펴본다. 또한 이번 장에서는 관계형 데이터베이스와 NoSQL 데이터베이스에서 데이터를 추출하는 방법도 이야기한다. 이번 장을 마치면 여러분은 파이썬과 NiFi, 에어플로를 이용해서 데이터베이스를 다루는 데 필요한 기술들을 갖추게 될 것이다. --- p.69 이번 장에서는 실무(production)에 바로 사용할 수 있는 데이터 파이프라인의 여러 특징을 살펴본다. 데이터 파이프라인을 여러 번 실행해도 결과가 변하지 않게 하려면 어떻게 해야 하는지(멱등성), 트랜잭션이 실패했을 때 어떻게 처리해야 하는지(원자성) 배우게 될 것이다. 또한 이번 장에서는 스테이징 환경에서 데이터를 검증하는 방법도 살펴본다. 이번 장의 예제 데이터 파이프라인은 내가 실무 환경에서 실제로 실행 중인 데이터 파이프라인이다. --- p.147 |
출판사 리뷰
|
실시간 데이터 파이프라인을 구축, 모니터링 및 관리하고,
Apache 프로젝트를 사용하여 효율적인 데이터 엔지니어링 인프라를 생성한다! 이 책은 데이터 공학의 기초를 소개하고, 대형 데이터 집합을 다루는 데이터 파이프라인을 구축하는 데 필요한 다양한 기술과 프레임워크를 개괄한다. 여러 예제를 통해 데이터를 정제하고 변환하는 방법과 데이터를 분석해서 데이터에서 최대한 많은 것을 얻는 방법을 배우게 될 것이다. 또한, 이 책은 복잡하고 덩치 큰 데이터를 다루는 방법과 실무 환경에 적합한 데이터 파이프라인을 구축하고 관리하는 방법도 설명한다. 현실적인 예제를 통해서는 데이터 파이프라인을 위한 기반 구조를 구축하고 실무 환경에 데이터 파이프라인을 배치하는 방법을 배우게 될 것이다. 이 책을 다 읽고 나면 파이썬과 오픈소스 프로젝트들을 이용한 데이터 공학이 어떤 것인지 확실하게 이해하게 될 것이며, 데이터를 추출하고, 그 품질을 점검하고, 용도에 맞게 적절히 변환하는 데이터 파이프라인을 구축해낼 수 있는 자신감이 생길 것이다. 이 책의 특징 및 구성 - 데이터 과학 및 분석 작업을 지원하는 데이터 공학자의 역할과 임무 - 파일과 데이터베이스에서 데이터를 추출하는 방법과 데이터를 정제하고, 변환하고, 증강하는 방법 - 다양한 형식의 파일을 읽고 쓰는 방법과 SQL 및 NoSQL 데이터베이스를 다루는 방법 - 데이터 파이프라인을 구축하고 대시보드를 이용해서 데이터 흐름을 시각화하는 방법 - 데이터를 웨어하우스에 적재하기 전에 스테이징과 검증 단계를 이용해서 데이터를 점검하는 방법 - 데이터를 검증하고 장애를 처리하는 스테이징 단계를 가진 실시간 데이터 파이프라인 구축 방법 - 데이터 파이프라인을 실무 환경에 배치하는 방법과 주의 사항 이 책의 대상 독자 - 데이터 공학자나 IT 전문가가 되고자 하는 학생 - 데이터 공학 분야에 진입하고자 하는 현업 개발자 - 실무에서 데이터를 추출-변환-적재해야 하는 현업 개발자 - 파이썬을 자신의 업무에 적용하고자 하는 기존 데이터 공학자 또는 데이터 분석가 |
