

소득공제
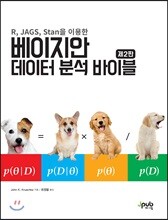
R, JAGS, Stan을 이용한
베이지안 데이터 분석 바이블
제2판 / 2019년 대한민국학술원 우수학술도서 선정도서
- 베스트
- 컴퓨터 공학 top100 9주
이미 소장하고 있다면 판매해 보세요.
- 해외배송 가능?
- 문화비소득공제 가능
이 상품의 태그



상세 이미지

책소개
목차
|
CHAPTER 1. 이 책에 대하여(먼저 읽기!) 1
1.1 누구나 이 책을 읽을 수 있다 1 1.2 이 책의 내용 3 1.3 2판에 새로 들어간 내용 6 1.4 (정중히) 피드백 보내기 8 1.5 감사의 글 9 PART 1. 기초: 모형, 확률, 베이즈 규칙, R 13 CHAPTER 2. 신뢰율, 모형, 파라미터 소개 15 2.1 베이지안 추론은 확률에 신뢰율을 재할당하는 것이다 16 2.2 확률은 기술 모형에서 파라미터값이다 22 2.3 베이지안 데이터 분석 단계 25 2.4 연습문제 32 CHAPTER 3. R 프로그래밍 언어 33 3.1 소프트웨어 다운로드 35 3.2 R 간단히 실행하기 36 3.3 R에 있는 간단한 명령어와 연산자 39 3.4 변수 유형 43 3.5 데이터 로딩과 저장 55 3.6 일부 유틸리티 함수 59 3.7 R 프로그래밍 64 3.8 그래프 그리기: 객체 열기, 저장하기 73 3.9 결론 74 3.10 연습문제 74 CHAPTER 4.확률이 뭘까? 77 4.1 가능한 모든 사건 집합 78 4.2 객관적이거나 주관적인 확률 80 4.3 확률분포 85 4.4 이원분포 96 4.5 부록: 그림 4.1에 대한 R 코드 100 4.6 연습문제 102 CHAPTER 5. 베이즈 규칙 105 5.1 베이즈 규칙 106 5.2 파라미터와 데이터에 적용하기 111 5.3 완벽 예제: 동전의 편향 추정 114 5.4 왜 베이지안 추론이 어려운가? 121 5.5 부록: 그림 5.1, 5.2의 R 코드 122 5.6 연습문제 124 PART 2. 이항확률 추론을 위한 기본지식 129 CHAPTER 6. 정확한 수학적 분석으로 이항확률 추론하기 131 6.1 가능도 함수: 베르누이 분포 132 6.2 신뢰율 기술: 베타분포 134 6.3 사후 베타분포 140 6.4 예제 142 6.5 요약 146 6.6 부록: 그림 6.4에 대한 R 코드 147 6.7 연습문제 148 CHAPTER 7. 마코프 연쇄 몬테카를로 151 7.1 표본이 큰 분포 근사하기 153 7.2 메트로폴리스 알고리즘 간단히 보기 154 7.3 더 일반적인 메트로폴리스 알고리즘 165 7.4 깁스 표본 추출: 두 동전의 편향 추정하기 170 7.5 MCMC 대표성, 정확도, 효율 187 7.6 요약 198 7.7 연습문제 199 CHAPTER 8. JAGS 203 8.1 JAGS와 R의 관계 203 8.2 완벽 예제 205 8.3 자주 사용하는 분석에 대한 간단한 스크립트 218 8.4 예제: 편향 차이 219 8.5 JAGS로 사전분포에서 표본 추출하기 224 8.6 JAGS에서 사용 가능한 확률분포 226 8.7 RunJAGS 병렬 처리를 통해 더 빠르게 표본 추출하기 228 8.8 JAGS 모형 확장에 대한 조언 231 8.9 연습문제 232 CHAPTER 9. 계층모형 235 9.1 어느 주조소에서 만든 하나의 동전 237 9.2 어느 주조소에서 만든 여러 개의 동전 245 9.3 계층모형 내 수축 262 9.4 JAGS 가속화 264 9.5 계층 확장: 범주 내 개체 267 9.6 연습문제 276 CHAPTER 10. 모형 비교와 계층모형화 281 10.1 일반식과 베이즈 인자 282 10.2 예제: 두 군데 동전 주조소 285 10.3 MCMC로 풀이 290 10.4 예측: 모형 평균화 307 10.5 자연적으로 설명되는 모형 복잡성 308 10.6 사전분포에 대한 극민감도 311 10.7 연습문제 315 CHAPTER 11. 영가설 유의성 검정 317 11.1 좋은 의도가 깔린 값 320 11.2 사전 지식 336 11.3 확신 구간과 최고밀도구간 339 11.4 다중비교 347 11.5 표본 추출 분포의 유용성 351 11.6 연습문제 354 CHAPTER 12. 베이지안 점(영)가설 추정 접근 357 12.1 추정 접근 358 12.2 모형 비교 접근 366 12.3 모형 추정과 모형 비교의 관계 376 12.4 추정 아니면 모형 비교? 378 12.5 연습문제 379 CHAPTER 13. 목표, 검정력, 표본크기 383 13.1 검정력 의지 384 13.2 계산력과 표본크기 390 13.3 순차 검정과 정확도 목표 409 13.4 토의 419 13.5 연습문제 423 CHAPTER 14. Stan 427 14.1 HMC 표본 추출 428 14.2 Stan 설치 435 14.3 완벽 예제 435 14.4 Stan으로 모형을 하향식으로 명시하기 443 14.5 한계와 추가 사항 444 14.6 연습문제 445 PART 3 일반선형모형 447 CHAPTER 15. 일반선형모형 개요 449 15.1 변수 유형 450 15.2 예측 변수의 선형조합 454 15.3 조합된 예측 변수로부터 노이즈가 있는 예상 데이터로 연결하기 465 15.4 GLM을 식으로 나타내기 474 15.5 연습문제 477 CHAPTER 16.한 개나 두 개 집단에 대한 계량 예상 변수 479 16.1 정규분포의 평균과 표준편차 추정 480 16.2 이상치와 로버스트 추정: t분포 489 16.3 두 개 집단 498 16.4 다른 노이즈 분포와 데이터 변환 504 16.5 연습문제 505 CHAPTER 17. 계량형 예측 변수가 하나인 계량형 예상 변수 509 17.1 단순선형회귀 510 17.2 로버스트 선형회귀 512 17.3 집단 내 개체에 대한 계층 회귀 523 17.4 이차 추세와 가중된 데이터 529 17.5 모형 확장에 대한 단계와 위험성 535 17.6 연습문제 540 CHAPTER 18. 계량형 예측 변수가 다수인 계량형 예상 변수 543 18.1 다중선형회귀 544 18.2 계량 예측 변수의 곱셈 상호작용 560 18.3 회귀계수의 수축 565 18.4 변수 선택 571 18.5 연습문제 586 CHAPTER 19. 단일 명목형 예측 변수와 계량형 예상 변수 589 19.1 계량 데이터의 다중 집단 기술하기 590 19.2 전통적인 분산분석 592 19.3 계층적 베이지안 접근 방식 593 19.4 계량 예측 변수 포함 605 19.5 이분산과 외측치에 대한 견고성 610 19.6 연습문제 616 CHAPTER 20. 다중 명목형 예측 변수와 계량형 예상 변수 619 20.1 다중 명목 예측 변수가 있는 계량 데이터 집단 기술 620 20.2 계층적 베이지안 접근 방식 624 20.3 재스케일화는 상호작용, 등분산성, 정규성을 변화시킬 수 있다 635 20.4 이상치에 대한 이분산과 견고성 638 20.5 개체 내 설계 642 20.6 모형 비교 접근 653 20.7 연습문제 656 CHAPTER 21. 이분형 예상 변수 659 21.1 다중 계량형 예측 변수 660 21.2 회귀계수 해석 668 21.3 로버스트 로지스틱 회귀 673 21.4 명목형 예측 변수 675 21.5 연습문제 685 CHAPTER 22. 명목형 예상 변수 689 22.1 소프트맥스 회귀 690 22.2 조건부 로지스틱 회귀 695 22.3 JAGS 실행 699 22.4 모형 일반화와 변형 708 22.5 연습문제 709 CHAPTER 23. 순서형 예상 변수 711 23.1 잠재된 계량형 변수가 있는 순서형 데이터의 모형화 712 23.2 단일 집단 사례 715 23.3 두 개 집단 사례 722 23.4 계량형 예측 변수 사례 727 23.5 사후 예측 739 23.6 일반화와 확장 740 23.7 연습문제 741 CHAPTER 24. 계수형 예상 변수 745 24.1 푸아송 지수 모형 746 24.2 머리카락과 눈색 다시 보기 753 24.3 상호작용 대비, 수축, 총괄 검정의 예 755 24.4 분할표에 대한 로그 선형모형 757 24.5 연습문제 758 CHAPTER 25. 트렁크 속 도구 763 25.1 베이지안 분석 보고 763 25.2 최고밀도구간 계산 함수 767 25.3 재파라미터화 771 25.4 JAGS에서의 검열 데이터 774 25.5 앞으로 할 일은? 779 참고문헌 781 찾아보기 792 |
저자 소개 2
John Kruschke
크러슈케 박사는 미국 인디아나 블루밍턴에 있는 인디애나대학교에서 심리학 뇌과학과와 통계학과의 겸임교수로 있다. 그는 인디애나대학교에서 우수강의상을 여덟 차례나 수상했으며, 미국 국립 과학원에서 트롤랜드(Troland) 연구상을 받았고, 인디애나대학교로부터 레막(Remak) 특별 연구자상도 받았다. 그는 독자, 그리고 동물에게 친절하다.
KAIST에서 이론물리학을 전공하고, 인공위성을 수출하는 우주항공 전문기업 쎄트렉아이에서 인공위성 영상을 분석하는 데이터 과학자로 일했다. 지금은 쎄트렉아이의 자회사인 에스아이에이(SIA)에서 인공지능연구소장을 맡고 있다. 주 연구 분야는 베이지안 딥러닝이며, 모델의 불확실성을 베이지안 방법으로 측정하는 기술에 대해 연구·개발하고, 최근에는 딥 뉴럴 네트워크가 결과를 판단할 때 주시하는 영역을 시각화해서 사용자가 이해할 수 있게 하는 설명화 인공지능(Explainable AI)에 대해 몰두하고 있다. 좌우명은 ‘2% 과학적인 한국인’이다.
품목정보
- 발행일
- 2018년 12월 20일
- 쪽수, 무게, 크기
- 816쪽 | 1552g | 188*245*39mm
- ISBN13
- 9791188621316
책 속으로
|
이번 장의 목표는 베이지안 데이터 분석의 개념적인 구조를 소개하는 것이다. 첫 번째 개념은 베이지안 추론이 확률에 신뢰율(credibility)을 재할당한다는 점이다. 두 번째 핵심 개념은 신뢰율을 할당받은 확률이 의미 있는 수학 모형에서는 파라미터값이 된다는 점이다. 이 두 핵심 개념이 이 책에 나온 모든 분석의 기초가 된다. 이번 장에서 이 개념에 대해 간단한 보기를 보여주려 한다. 이 두 개념을 응용 프로그램으로 구체화시켜 이 책의 나머지 부분을 세부적인 수식과 계산으로 채우는 일이 전부라고 할 수 있다. 또한 모든 베이지안 분석이 공통으로 갖는 절차상의 기본 단계를 설명한다.
--- p. 15 R에서 모든 객체(object)는 객체 내 구조와 내용의 타입을 나타낼 수 있는 클래스(class)를 갖는데, 일부 함수로 인식될 수 있어서 함수는 서로 다른 객체 클래스를 서로 다른 방식으로 취급한다. 예를 들어 객체는 matrix, array, list, factor, data.frame 등의 클래스일 수 있다. 앞서 언급한 summary 함수는 인수 클래스를 감지하고 팩터와는 다른 수치형 벡터를 요약해준다. --- p. 43 큰 위험을 감수해야 하는 게임에서는 동전이 공정하느냐가 매우 중요하다. 하지만 보통 일상에서 동전을 던져 나온 결과는 그렇게 대수롭지 않다. 그렇다면 왜 굳이 동전 던지기 통계를 공부해야만 하는가? 그 이유는 우리가 관심 있어 하는 실제 세상의 여러 사건을 대신해주기 때문이다. 심장 수술의 경우, 1년 이상 생존 또는 아님으로 환자 결과를 나눌 수 있고, 1년 이상 생존하는 환자의 확률을 알고 싶을 수 있다. 약의 경우, 두통 발생 또는 아님으로 결과를 나눌 수 있고, 두통 발생 확률이 궁금할 수 있다. 설문용 질문의 경우, 결과는 동의함 또는 동의 안 함이 되고, 각 응답 확률을 알고 싶을 수 있다. 두 명의 후보 중 한 사람에게 투표하는 경우, 후보 A와 후보 B가 두 결과가 되고 투표 전에 후보 A가 승리할 확률을 여론조사로부터 예측하고 싶을 수 있다. 다문항 시험의 경우, 문항 답이 맞는지 틀린지 정확도를 측정하는 수리력을 연구할 수도 있다. 또는 서로 다른 하위 모집단 안에서 특정 인지 과정의 뇌 편향(brain lateralization)을 연구하는 경우, 결과는 오른쪽 편향이나 왼쪽 편향 중 하나인데 하위 모집단 안에서 왼쪽 편향일 확률을 예측할 수도 있다. --- p. 79 독자가 지금 사는 곳에서 평범한 날에 구름 낄 확률은 얼마인가? 비가 내리고 있다는 일기예보를 들었다고 가정하면 구름 낄 확률은 얼마일까? 이 두 확률이 같지 않다는 점에 주의해야 한다. 왜냐하면 p(구름) p(구름|비)라고 아주 잘 알고 있기 때문이다. 대신 지금 밖에 있는 사람들이 모두 선글라스를 끼고 있다고 생각해보자. p(구름) p(구름|선글라스)가 가장 그럴듯하다. 기상과 관련한 이 예제에서 우리가 어떻게 추론했는지 잘 생각해보자. 하늘의 두 가지 상태, 구름 낌 또는 맑음에 대한 사전 신뢰율부터 시작했다. 그런 다음에 다른 몇몇 데이터, 즉 비가 온다거나 사람들이 선글라스를 끼고 있다는 것을 고려했다. 새로운 데이터 조건으로 가능한 하늘 상태에 대해 신뢰율을 재할당했다. 새로운 데이터가 비가 온다일 때, 처음보다 더 구름 낌을 신뢰하게 되었다. 대신 데이터가 선글라스에 대한 것일 때 구름 낌을 처음보다 덜 신뢰하게 되었다. 베이즈 규칙은 단순히 신뢰율을 사전 할당하는 것과 데이터에 조건해서 신뢰율을 사후 할당하는 것 사이의 수학적 관계를 뜻한다. --- p. 105 이번 장에서는 어떤 근사법도 쓰지 않고 순전히 해석학만을 사용해서 어떻게 베이지안 추론을 하는지에 대한 예를 보여준다. 궁극적으로 복잡한 응용 예제에 필요한 해석학적 접근은 하지 않겠지만 두 가지 이유에서 이번 장은 중요하다. 첫째, 이번 장에 나오는 상대적으로 간단한 수학을 통해 연속 파라미터에 대한 베이지안 추론의 기초 개념을 잘 파악할 수 있다. 데이터가 쌓이면서 신뢰율을 연속으로 할당하는 법을 간단한 식으로 보여준다. 여기에 나온 보기들은 다음에 나올 근사법에 대한 개념을 세우는 데 중요한데, 그 이유는 근사를 어디에 적용할지를 명확히 알 수 있게 해주기 때문이다. 둘째, 이번 장에서 소개하는 분포, 특히 베타분포는 이후에 나오는 몇몇 장에서 반복적으로 등장할 것이므로 잘 알아두는 것이 좋다. --- p. 131 |
출판사 리뷰
|
데이터 분석을 위한 최고의 베이지안 이론서!
이 책은 잘 알려진 무료 소프트웨어인 R, JAGS, Stan을 이용해 베이지안 데이터 분석을 수행하는 방법을 단계별로 설명한다. 입문 수준의 독자도 쉽게 이해할 수 있는 확률과 베이즈 규칙부터 시작해서 직접 구현할 수 있는 베이지안 데이터 분석을 위한 고급 응용 프로그램까지 베이지안 분석을 위한 튼튼한 토대를 제공한다. 복잡한 내용을 쉽게 이해할 수 있도록 연관성 있는 자료와 풍부한 그림, 수많은 연습문제를 실었다. 또한, 이 책에서 배운 방법을 독자의 데이터에 적용하는 데 도움을 주기 위해 검정력 분석과 표본크기 계획 같은 확장된 범위의 주제를 다루고, 독자의 응용 프로그램과 데이터에 사용할 수 있는 새롭고 완벽한 R 프로그램을 제공한다. 2판에서는 완전히 새로 고친 도입부를 포함해 수많은 그림과 R, JAGS, Stan에 대한 설명, 그리고 최신 프로그램들에 관한 소개 등이 새롭게 추가됐다. 이 책의 주요 내용 · 확률과 베이즈 규칙 · 베이지안 다중회귀 · 분산분석(ANOVA) · 로지스틱 회귀 · 분할표 분석 · 모형 비교 · 영가설 검정 · 계층모형 · 표본크기 계획 · 베이지안 검정력 분석 |
